Hyprism: como nascem projetos open source
Como minhas configurações do Hyprland viraram um pequeno projeto open source e o que isso revelou sobre defaults, instalação, releases, AUR e manutenção.
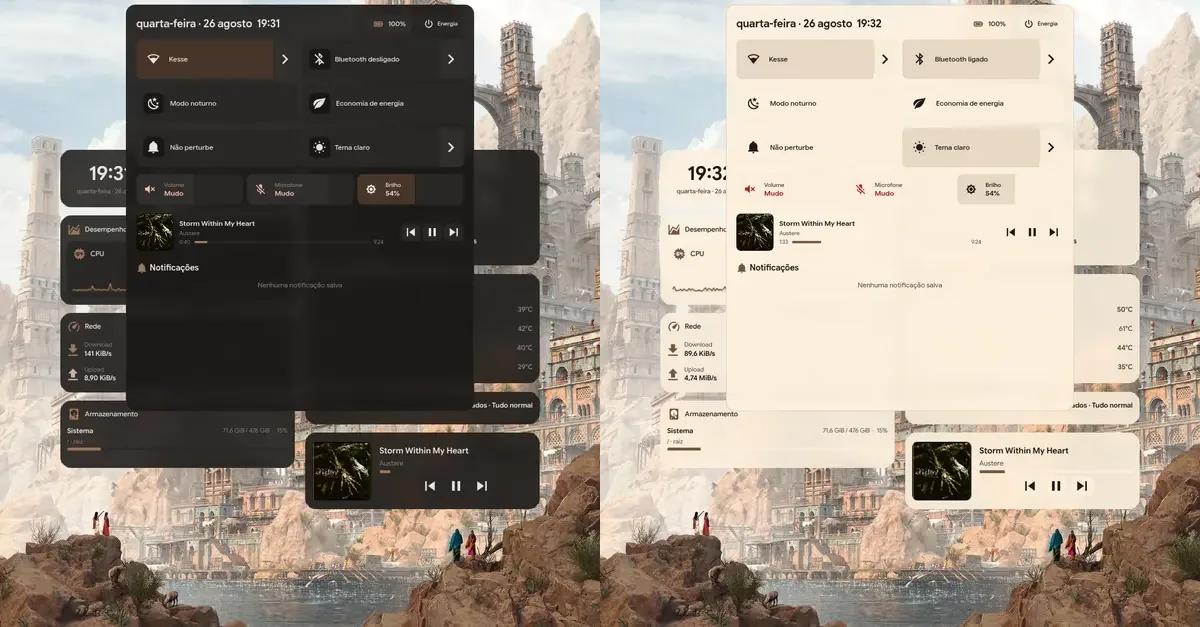
Repositórios costumam parecer muito mais deliberados quando vistos de fora. Existe um nome, um README organizado, versões numeradas, scripts de instalação e, se tudo correu bem, alguma automação que publica pacotes. O histórico final sugere um plano. Na prática, muitos projetos open source começam de um jeito bem menos solene: alguém tinha um problema irritante e escreveu alguma coisa para parar de lidar com ele manualmente.
O Hyprism começou assim. Antes do nome, das releases e dos pacotes no AUR, ele era a configuração do meu desktop com Hyprland. Eu queria uma sessão que funcionasse do meu jeito, com um shell em Quickshell, widgets próprios e uma paleta derivada do wallpaper. Naquele contexto, não havia nada de errado em assumir meus diretórios, meus programas, meu monitor, meu idioma e meus teclados. Dotfiles pessoais existem justamente para codificar esse tipo de preferência.
O projeto mudou de natureza quando outras pessoas quiseram instalar o que eu havia publicado. A partir desse ponto, o problema já não era apenas fazer o desktop funcionar. Era descobrir quais partes dele funcionavam porque o código estava correto e quais funcionavam porque a máquina era a minha.
Essa distinção parece pequena enquanto só existe um usuário. Ela fica bastante concreta quando aparece a segunda máquina.
Um desktop feito para uma pessoa
O repositório do Hyprism começa em 10 de agosto de 2026 com um README vazio. Os commits seguintes já adicionam a configuração do Hyprland, o pipeline de wallpaper e tema, scripts de sistema, um user.json, listas de pacotes e a primeira versão do shell em Quickshell. O primeiro install.sh também entrou naquele dia. Havia desde cedo uma preocupação com reproduzir o ambiente, mas reprodução ainda significava, em grande parte, conseguir reconstruir o meu próprio desktop.
A base técnica já era parecida com a atual. O Hyprland gerenciava a sessão e as janelas. O Quickshell fornecia a interface em QML, incluindo a barra em formato de ilha, launcher, controles, notificações e widgets. O Matugen extraía uma paleta do wallpaper, e scripts distribuíam essas cores para o restante do ambiente.
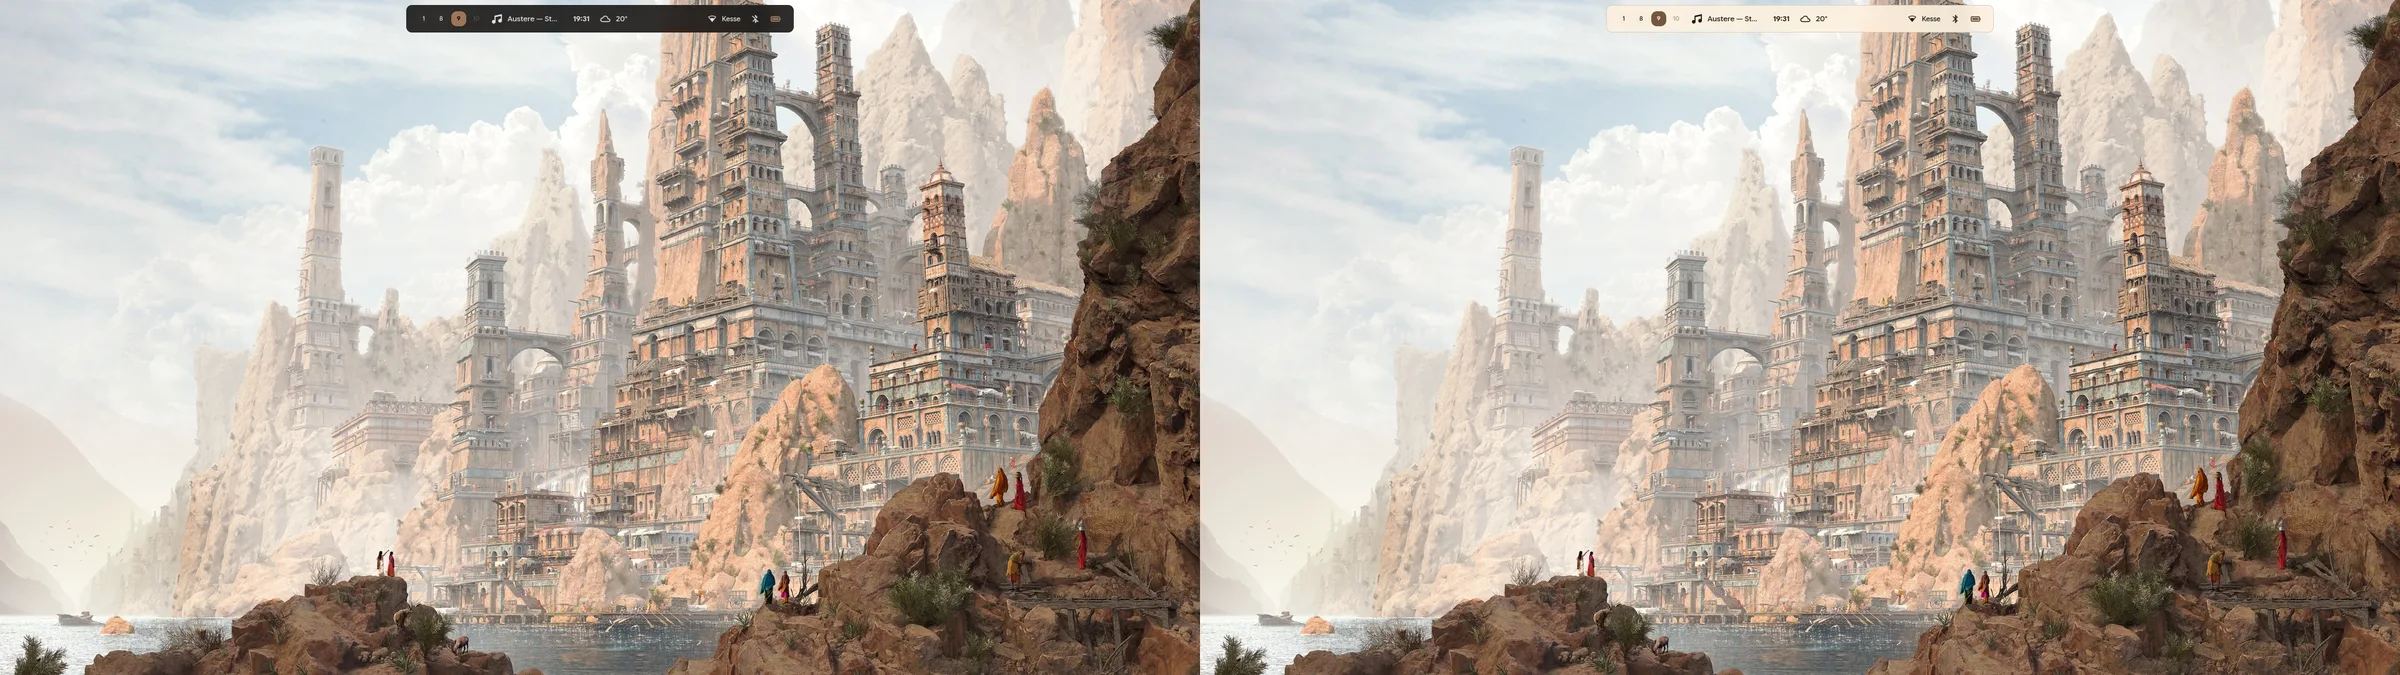
O desktop atual mantém a mesma ideia inicial: o wallpaper orienta a aparência, enquanto o shell concentra a interação da sessão.
Para uso pessoal, esse arranjo simplificava várias decisões. Os wallpapers podiam ficar em ~/Imagens/Wallpapers; a localização inicial do clima podia ser São Paulo; um atalho podia abrir o navegador que eu usava; os identificadores dos meus teclados podiam aparecer diretamente no arquivo de input. Se alguma coisa quebrasse, eu sabia qual arquivo abrir porque tinha acabado de escrevê-lo.
Isso não era falta de engenharia. Era uma delimitação de escopo perfeitamente razoável. Software pessoal não precisa começar portátil, traduzível e empacotado para ser útil. Tentar resolver todas as combinações possíveis antes de a ideia funcionar para alguém costuma produzir abstração demais e utilidade de menos.
O problema é que um instalador pode dar uma impressão de generalidade que o restante do código ainda não tem. O primeiro script conseguia colocar os arquivos nos lugares esperados e instalar dependências no Arch Linux, mas também carregava várias decisões pessoais junto. Ter automatizado a cópia não tornava essas decisões universais. Só fazia com que chegassem mais rápido à próxima máquina.
A segunda máquina entra no projeto
Quando compartilhei o Hyprism no Reddit, em 23 de agosto, a apresentação ainda era a de um rice pessoal que havia crescido até virar um shell mais completo. O repositório estava disponível para quem quisesse estudar, testar ou aproveitar partes, mas isso não equivalia a oferecer uma experiência de instalação previsível.
Dois dias depois, outro post mostrou o estado do shell após 218 commits. Entre as respostas, alguém perguntou onde podia baixá-lo. Minha orientação foi enviar o repositório e avisar que a interface estava em português. Para quem não falasse o idioma, a sugestão naquele momento era fazer um fork e traduzir os painéis do Quickshell.
Era uma resposta coerente com dotfiles pessoais e ruim para software distribuído. A pessoa não estava interessada em adotar a minha configuração como material de estudo. Ela queria instalar o programa.
Esse interesse externo não transformou o Hyprism num grande projeto. Continuava sendo um shell pequeno, mantido por uma pessoa no tempo livre. Ainda assim, ele passou a enfrentar problemas que não existiam enquanto o repositório servia apenas como extensão da minha máquina. Idioma deixou de ser texto espalhado pelo QML. Caminhos deixaram de ser apenas diretórios convenientes. Configuração deixou de significar “edite o arquivo até ficar como você quer”. Atualização passou a precisar preservar escolhas que eu não conhecia.
No dia 26, o commit 8d97edf introduziu catálogos em config/quickshell/i18n/en.json e pt-BR.json. O singleton I18n.qml carrega as traduções, observa mudanças nos arquivos e usa o inglês como fallback para chaves ausentes. O inglês virou o idioma inicial de novas instalações, enquanto o português brasileiro continuou disponível e pode ser trocado durante a sessão:
hyprism-shell language set en
hyprism-shell language set pt-BR
Inglês não é um idioma neutro, mas era um padrão menos ligado à minha localização. A mudança mais importante, porém, não foi escolher outra língua. Foi tirar o idioma da implementação e tratá-lo como uma preferência. O texto dos painéis passou a ter um lugar próprio, uma política de fallback e uma interface para alteração.
O mesmo movimento começou a acontecer com o restante do ambiente. O config/user.json, que já existia desde os primeiros commits, passou a concentrar aparência, caminhos, monitor principal, geometria do shell, widgets, clima, serviços e, mais tarde, teclado. Isso criou uma separação entre o que o projeto distribui e o que o usuário escolhe. Também criou a obrigação de manter essa separação durante updates.
O teclado que estava certo na máquina errada
O caso mais claro apareceu no arquivo de input do Hyprland. Meu notebook tem teclado brasileiro ABNT2. O teclado externo que uso é US International. A configuração original representava exatamente esse hardware: br era o layout geral e do teclado interno, enquanto uma lista de identificadores dos meus dispositivos externos recebia us com a variante intl.
Na minha máquina, a configuração estava correta. O erro foi deixá-la atravessar a fronteira como padrão público.
Um usuário relatou no Reddit que tinha um teclado incomum e ficou perdido porque a instalação forçava o layout brasileiro. Ele conseguiu ajustar manualmente a configuração do Hyprland, mas o relato expôs algo mais interessante do que a ausência de suporte a um modelo específico. Eu havia transformado um fato pessoal em política do software sem perceber.
Minha reação inicial foi considerar us-intl como novo padrão. Isso reduziria a chance de repetir exatamente o mesmo problema, mas manteria a falha de raciocínio. O projeto ainda escolheria silenciosamente um layout com base numa estimativa sobre quem poderia instalá-lo.
A solução implementada no commit 07e3a08, em 28 de agosto, removeu do arquivo distribuído tanto o layout brasileiro quanto a lista dos meus teclados externos. O comportamento atual é preservar o layout detectado no sistema até que exista uma escolha explícita no user.json. Um padrão do projeto, um estado observado na máquina e uma preferência do usuário deixaram de ser tratados como a mesma coisa.
O relato também trouxe uma restrição de interface curiosa. Quando o layout está errado, digitar o comando necessário para corrigir o layout pode ser justamente o que está difícil. Exigir que a pessoa escrevesse identificadores XKB e nomes de dispositivos naquele estado seria tecnicamente possível e ergonomicamente meio cruel.
Por isso hyprism-shell keyboard setup abre uma TUI navegável principalmente com setas, Enter e Esc:
hyprism-shell keyboard setup
O backend consulta hyprctl devices -j, lê os teclados conhecidos pelo Hyprland e cruza essas informações com metadados do sistema. Interfaces HID pertencentes ao mesmo dispositivo são agrupadas, e endpoints auxiliares, como controles multimídia expostos por alguns receptores, ficam fora do fluxo normal de configuração. A TUI permite escolher o teclado físico, selecionar um preset comum ou qualquer layout XKB instalado e aplicar uma prévia temporária.
Durante a prévia, o usuário pode digitar para confirmar se as teclas produzem o resultado esperado. Enter salva a escolha para aquele dispositivo; Esc reaplica o estado anterior. Fora da TUI, a CLI também permite configurar um layout padrão ou selecionar grupos como teclado interno, externo e todos os dispositivos. Depois de gravar o user.json, o backend gera um pequeno arquivo Lua carregado pelo módulo de input do Hyprland.
Os mesmos recursos continuam disponíveis de forma não interativa para inspeção e automação:
hyprism-shell keyboard devices
hyprism-shell keyboard get
hyprism-shell keyboard set external us-intl
Nada disso transforma configuração de teclado em um problema gigantesco. É um bug pequeno. Justamente por isso ele funciona tão bem como exemplo: uma suposição pode passar meses despercebida quando o desenvolvedor e o usuário são a mesma pessoa. Basta uma instalação em hardware diferente para ela ganhar nome, reprodução e consequência de design.
O problema nunca esteve apenas no input.lua. Ele estava no fato de eu ainda não ter precisado distinguir configuração pessoal de configuração distribuível.
Configuração precisa de uma interface
Separar preferências num JSON evita espalhá-las pelo QML e pelos scripts, mas um arquivo de configuração não resolve tudo sozinho. Para mim, editar uma propriedade aninhada era simples porque eu conhecia a estrutura interna. Para outra pessoa, descobrir qual campo mudar, quais valores são válidos e se o shell precisa ser reiniciado já fazia parte da experiência do projeto.
Foi nesse contexto que surgiu o hyprism-shell. A CLI começou reunindo ações para widgets, clima, idioma, wallpaper, screenshots, lock, reload e painéis. Depois incorporou aparência, agendamento de tema, temperatura do branco, teclado, serviços monitorados e inicialização de instalações empacotadas. Ela não substitui todas as opções do user.json, mas cria uma fronteira estável para as mudanças mais comuns:
hyprism-shell widgets toggle weather
hyprism-shell weather location "São Paulo"
hyprism-shell theme schedule set 07:00 18:30 --enable
hyprism-shell wallpaper random
A diferença não é apenas conveniência. A ferramenta valida os argumentos, preserva valores não relacionados, escreve a configuração de forma atômica e aciona a atualização necessária. Em vez de ensinar a estrutura interna do arquivo para cada operação, o projeto expõe uma intenção: alterar idioma, desligar um widget, configurar um horário ou escolher um layout.
Quando usuários e documentação passam a depender desses comandos, a CLI também adquire um custo de compatibilidade. Renomear um subcomando, mudar um código de saída ou alterar o formato produzido por uma consulta deixa de ser uma refatoração inteiramente interna. É uma API pequena, com poucos consumidores, mas continua sendo uma interface pública.
O widget de serviços mostrou outra parte desse problema. A configuração original acompanhava NetworkManager, Bluetooth e PipeWire porque eram as unidades que faziam sentido no meu ambiente. O commit 0882b30 adicionou comandos para consultar e alterar essa lista:
hyprism-shell services list
hyprism-shell services add bluetooth.service
hyprism-shell services add pipewire.service --user
hyprism-shell services remove bluetooth.service
Essas operações apenas definem o que será observado. Elas não iniciam, param ou habilitam unidades. Nomes sem sufixo são normalizados para .service, tipos explícitos como .timer e .socket são preservados, e a unidade é validada antes de entrar na configuração.
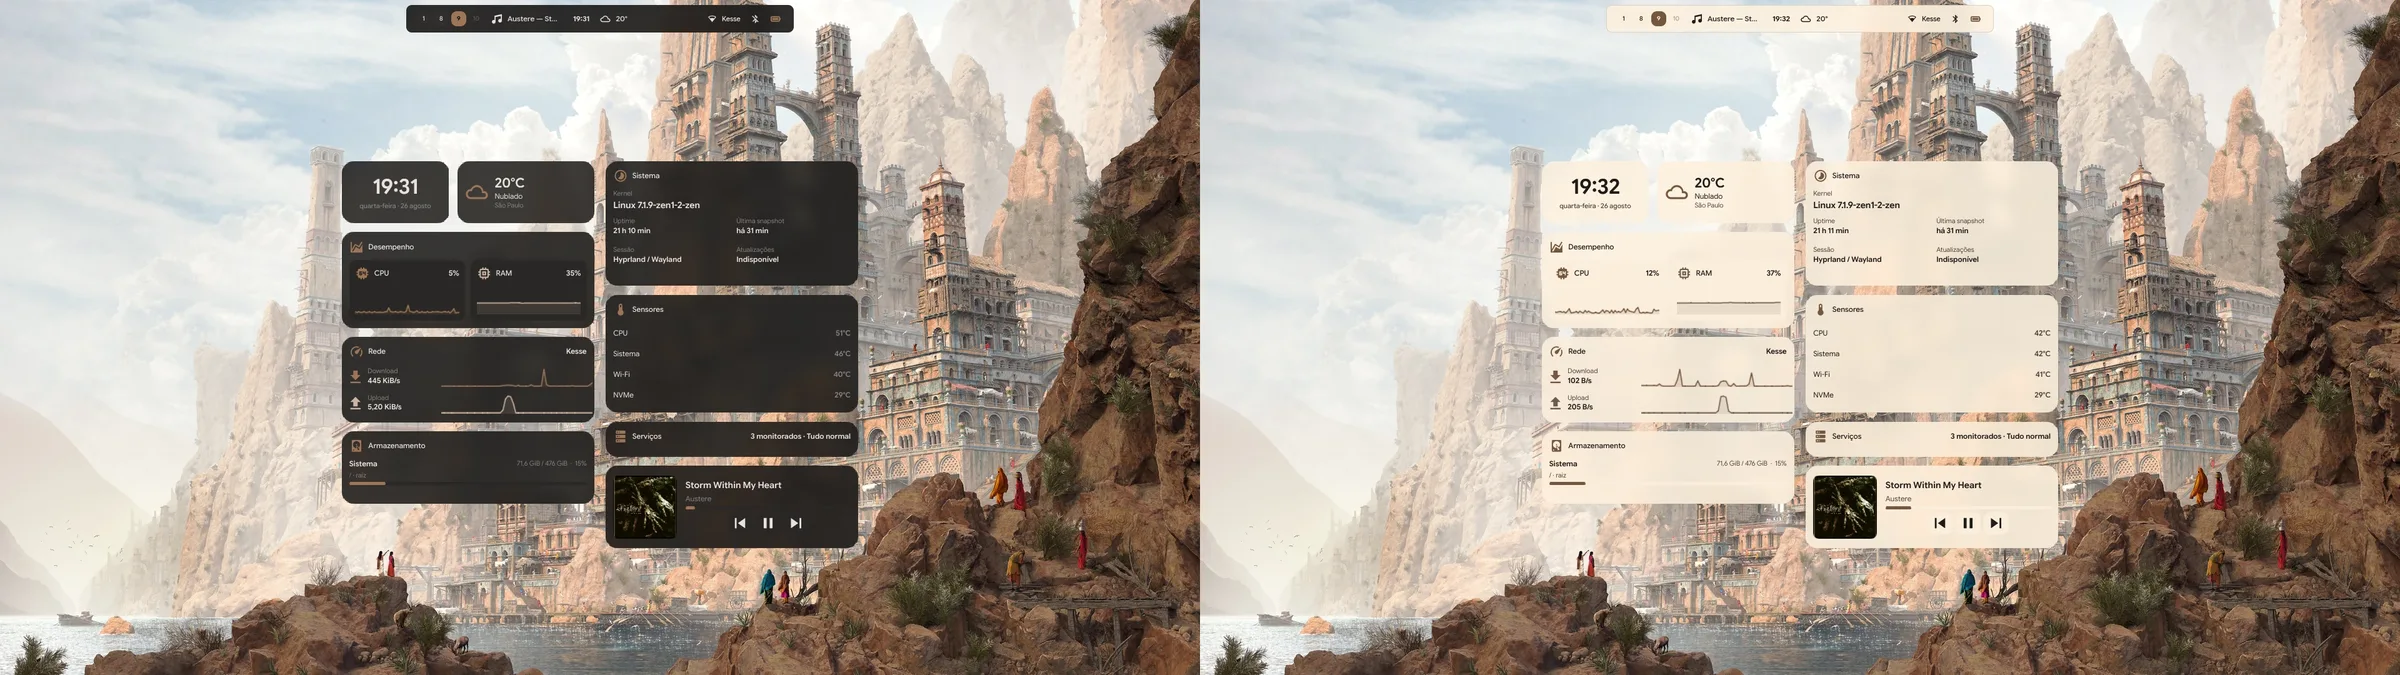
Os widgets transformaram informações inicialmente escolhidas para a minha sessão, como clima e serviços, em estado configurável pelo usuário.
Persistir a nova lista ainda não era suficiente. O daemon de monitoramento já podia estar rodando com uma representação anterior do user.json. Alterar o arquivo no disco e continuar exibindo o serviço removido era um comportamento inconsistente, mesmo que tudo voltasse ao normal após reiniciar o shell.
No commit 16717be, o Quickshell ganhou uma revisão de configuração. Sempre que o JSON é recarregado, essa revisão muda e o serviço de monitoramento reinicia com os valores atuais. O caso é pequeno, mas mostra duas camadas que software pessoal frequentemente mistura: o estado persistido e o estado que um processo vivo está usando agora.
Se existe um comando público dizendo que removeu um item, esperar o próximo login para a interface concordar deixa de ser um detalhe do desenvolvedor.
Uma troca de wallpaper e vários consumidores
O pipeline de temas cresceu pelo mesmo motivo. Para quem usa o desktop, a ação continua simples: escolher um wallpaper e ver o ambiente acompanhar suas cores. A implementação precisa coordenar programas que usam formatos, toolkits e mecanismos de atualização diferentes.
Atualmente, scripts/theme/generate-theme.py executa o Matugen uma vez com --dry-run --json. Essa saída funciona como fonte comum para uma paleta semântica. A partir dela, o Hyprism produz configurações para Quickshell, Hyprland, Hyprlock, SDDM, GTK com Colloid, Qt com Kvantum, Kitty, Foot, hyprtoolkit, Starship, tmux, Neovim, Fastfetch e Zathura. O script também deriva um tema de ícones do Papirus, recolorindo os SVGs necessários sem modificar a instalação original.
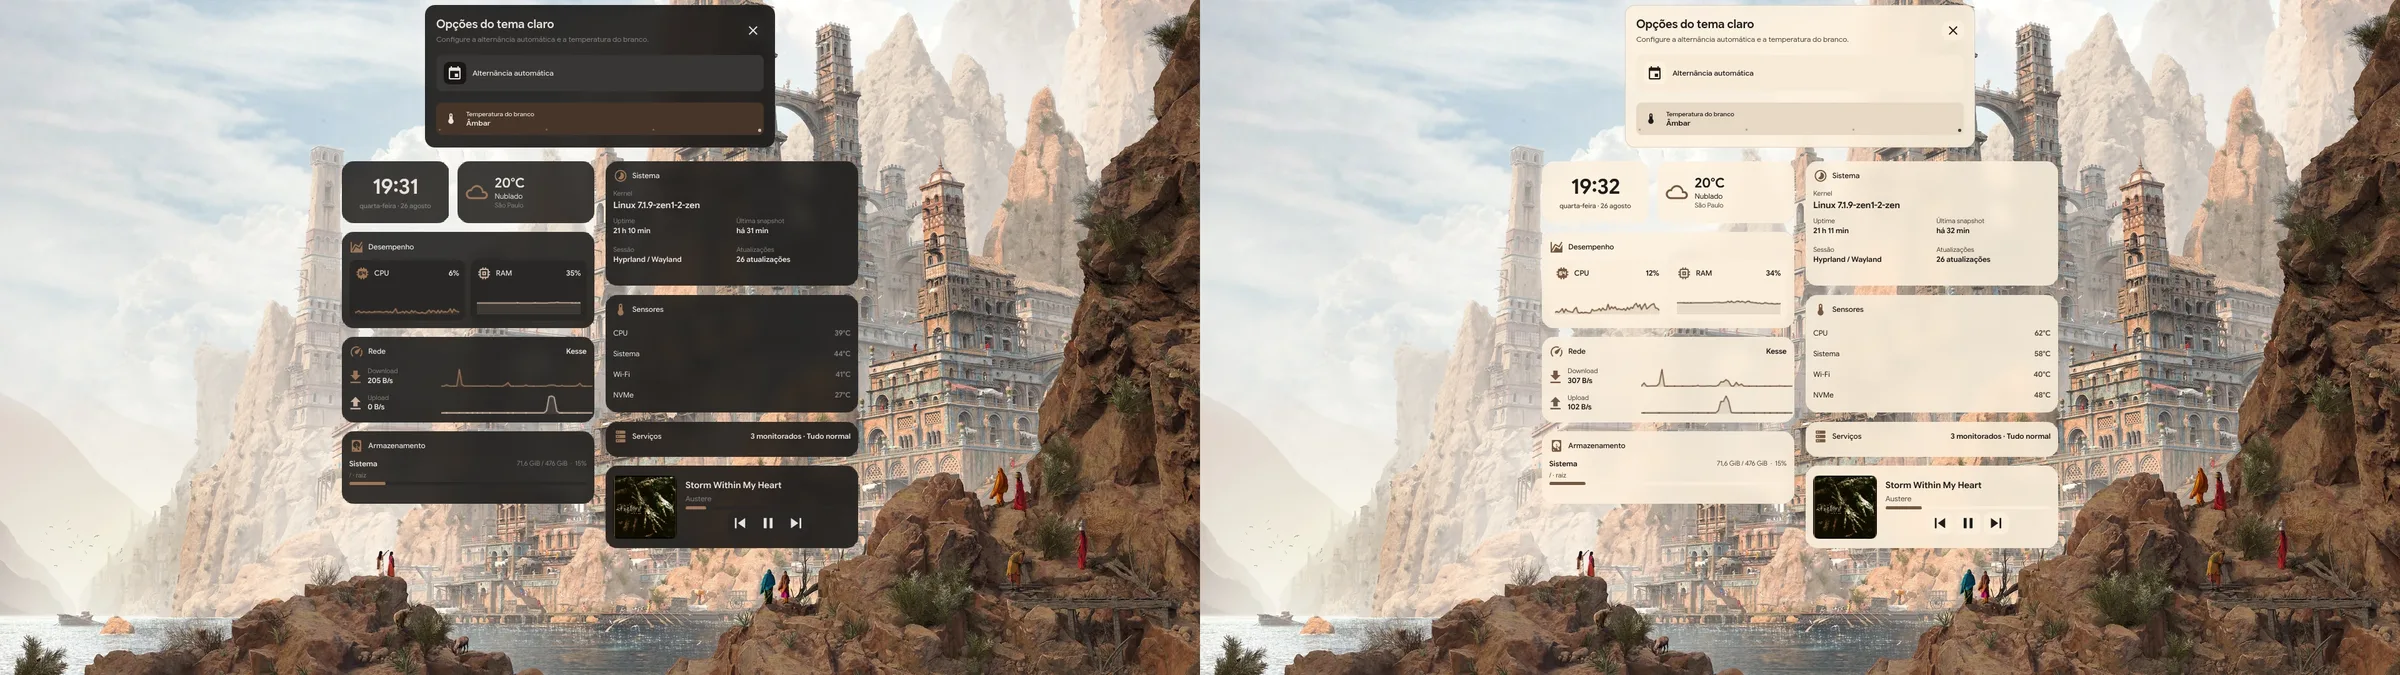
Tema claro e escuro compartilham a paleta derivada do wallpaper; o usuário também pode configurar alternância por horário e temperatura do branco.
Nem todos os consumidores reagem da mesma forma. Alguns aceitam atualização ao vivo; outros dependem de reload, reconstrução de cache ou geração de arquivos. O script evita gravar novamente conteúdos idênticos, só reconstrói o tema Colloid quando a paleta correspondente muda e valida várias saídas antes de substituir uma configuração anterior.
Esse cuidado não existe apenas para economizar alguns milissegundos. Num pipeline com muitos destinos, uma falha intermediária pode deixar metade da sessão com a paleta nova e outra metade com a antiga. O que parece uma feature visual passa a ser um problema de publicação de estado entre ferramentas independentes.
Software distribuído acumula muitas dessas desproporções. A ação do usuário cabe num botão. A quantidade de integração necessária para torná-la previsível raramente cabe.
Instalação também faz parte do programa
Código público não é sinônimo de software distribuível. Um repositório pode conter tudo que alguém precisa e ainda exigir conhecimento demais para ser instalado, atualizado ou removido sem a ajuda do autor.
Por algum tempo, a instalação do Hyprism consistia em clonar o repositório e executar install.sh. O script já era melhor do que copiar dotfiles manualmente, mas sua responsabilidade cresceu junto com o shell. Ele precisava lidar com pacotes, fontes, arquivos em ~/.config, comandos em ~/.local/bin, tema do SDDM, serviços de usuário, wallpapers, cache e estado inicial. Também precisava decidir o que fazer quando algum desses caminhos já existia.
Em 26 de agosto, o commit 6400dc1 adicionou um Makefile e um desinstalador. O repositório passou a expor operações com nomes estáveis:
make install
make install-ptbr
make update
make check
make reload
make uninstall
O instalador atual confirma que está num sistema Arch, verifica ferramentas básicas, provisiona pacotes e cria o runtime em ~/.local/share/hyprism. Se um caminho que o projeto precisa gerenciar já contém outra configuração, ele é movido para ~/.local/state/hyprism/backups/ antes que o link novo seja criado. O update reaplica a instalação sem provisionar pacotes novamente e preserva as preferências existentes.
O fluxo de remoção também recebeu uma política explícita. O desinstalador remove links que apontam para o runtime do Hyprism, mas arquiva o runtime e o user.json em ~/.local/state/hyprism/uninstalled/. Isso reduz o risco de uma avaliação do projeto virar perda definitiva de configuração.
Empacotar exigiu separar ainda melhor arquivos do projeto e estado do usuário. O alvo make install-system respeita PREFIX e DESTDIR, instala conteúdo compartilhado em /usr/share/hyprism e coloca a CLI em /usr/bin. O pacote não tenta escrever preferências em algum diretório home durante package(). Depois da instalação, hyprism-shell init combina os defaults fornecidos pelo pacote com o estado daquele usuário:
hyprism-shell init
hyprism-shell init --lang pt-BR
Essa inicialização pode ser executada novamente após uma atualização. A mesclagem inclui campos novos sem apagar escolhas existentes, e o JSON é substituído atomicamente. Defaults pertencem ao projeto e podem evoluir; preferências pertencem ao usuário e precisam sobreviver a essa evolução. Colocar os dois no mesmo arquivo sem uma estratégia de migração só adia o problema para a próxima versão.
Uma versão é um ponto de referência
O primeiro GitHub Release do Hyprism foi o v0.1.0, publicado em 27 de agosto. Naquele momento, o projeto já tinha instalação por Makefile, CLI, inglês e PT-BR, temas claro e escuro, agendamento, material visual e um README bem mais completo. O configurador de teclado e a publicação no AUR ainda não faziam parte da release; chegaram logo depois.
Publicar v0.1.0 não tornou o Hyprism estável por decreto. O número continuava indicando uma versão inicial, sujeita a mudanças e com bastante coisa para corrigir. O que ele ofereceu foi uma referência comum.
A branch main muda toda vez que recebe um commit. Um tag identifica um estado específico. Quando alguém relata um bug, passa a ser possível saber qual versão do código instalou e o que mudou desde então. A documentação pode se referir ao comportamento daquela versão. Um pacote estável pode consumir um arquivo imutável, verificar seu checksum e não depender do estado que main terá amanhã.
As releases seguintes refletem a velocidade desse período inicial. v0.1.1 e v0.1.2 corrigiram detalhes de tema no mesmo dia. v0.1.3 incorporou a base do empacotamento no AUR. v0.1.4 trouxe a configuração de teclado e o gerenciamento de serviços. v0.1.5 corrigiu a atualização reativa do widget de serviços e um detalhe visual do GTK. v0.1.6, publicada em 30 de agosto no horário UTC, restaurou atalhos do painel e era a versão estável atual durante a escrita deste texto.
Essa sequência não é importante como changelog. Ela mostra por que versionamento deixa de ser decoração assim que alguém instala o projeto. Sem uma versão, “o Hyprism não funciona” pode descrever qualquer estado entre o primeiro README e o commit mais recente.
Dois pacotes e três repositórios
Como o Hyprism mira Arch Linux e apareceu primeiro entre usuários de Hyprland, o AUR era um canal de distribuição natural. Mesmo sendo um projeto composto principalmente por QML, Python, Lua e shell, o empacotamento continuava útil. O pacote declara dependências, coloca os arquivos em caminhos conhecidos, registra o que pertence ao projeto e permite que updates sejam tratados pelo fluxo normal do sistema. Ser software interpretado elimina uma etapa de compilação, não a necessidade de instalação organizada.
Atualmente existem dois pacotes, com contratos diferentes:
| Pacote | Fonte acompanhada | Uso esperado |
|---|---|---|
hyprism-shell | Última release versionada | Instalação estável, baseada num tag e checksum conhecidos |
hyprism-shell-git | Branch main | Desenvolvimento atual, incluindo commits ainda não publicados em release |
O PKGBUILD.in do pacote estável recebe a versão da release e o SHA-256 do tarball correspondente. O arquivo final aponta para uma URL como archive/refs/tags/v0.1.6.tar.gz. Já o PKGBUILD da variante VCS usa git+https://github.com/kristyancarvalho/hyprism.git#branch=main e calcula pkgver() a partir do último tag alcançável, da quantidade de commits seguintes e do hash curto do HEAD. Quando main coincide com um tag, a versão pode ser apenas 0.1.6; quando avança, ganha uma forma como 0.1.6.r2.gabcdef0.
Os pacotes conflitam entre si porque oferecem a mesma interface e instalam os mesmos arquivos. A diferença não é de funcionalidade intencional, mas de política de atualização. Quem escolhe -git aceita acompanhar o desenvolvimento; quem instala o pacote estável espera receber uma release identificável.
O repositório principal no GitHub não é o repositório do AUR. O AUR mantém um repositório Git separado para hyprism-shell e outro para hyprism-shell-git. Eles não armazenam a implementação completa do shell. Armazenam a receita de pacote, principalmente PKGBUILD e .SRCINFO.
O PKGBUILD descreve como obter a fonte, quais dependências existem e quais arquivos entram no pacote. A .SRCINFO é uma representação dos metadados usada pelo AUR para indexar informações sem precisar executar o PKGBUILD. Sempre que a receita muda, os dois arquivos precisam permanecer sincronizados.
No Hyprism, scripts/aur/publish clona o repositório AUR apropriado, gera o PKGBUILD, executa makepkg --printsrcinfo para produzir .SRCINFO, verifica se houve diferença e cria um commit apenas quando necessário. O push é enviado por SSH para aur@aur.archlinux.org, no branch master do repositório do pacote.
Isso acrescenta uma fronteira de autenticação que não existia na publicação do código. O GitHub Actions precisa de uma chave SSH dedicada, armazenada no secret AUR_SSH_PRIVATE_KEY. Durante o job, a chave é instalada no home do usuário de build, aur.archlinux.org é incluído em known_hosts e uma configuração SSH limita aquela conexão à identidade correta. O token do GitHub serve para consultar releases; a chave SSH serve para publicar no AUR. São sistemas e credenciais diferentes.
O clone do CI não é o clone do desenvolvedor
A primeira automação do pacote estável falhou com uma mensagem equivalente a esta:
Latest GitHub release tag is unavailable locally: v0.1.3
O script consultava a API do GitHub e descobria corretamente que v0.1.3 era a release mais recente. Em seguida, tentava resolver o tag no checkout local do job. A release existia no GitHub, mas o ref correspondente não estava disponível naquele clone da forma esperada.
O conserto entrou no commit fe7e1f8. O workflow passou a fazer checkout de main com fetch-depth: 0 e fetch-tags: true. O script release-info também ganhou verificações adicionais: confirma que origin aponta para o upstream esperado, consulta o tag remoto com git ls-remote, busca o ref específico se ele ainda não existir localmente, compara os objetos local e remoto e verifica se o commit do tag é ancestral do HEAD de main.
Não era um problema na release nem no AUR. Era uma diferença entre ambientes Git. Meu clone de desenvolvimento já tinha o histórico e os tags necessários; o checkout criado dentro do Actions precisava declarar isso.
O fluxo atual pode ser resumido assim:
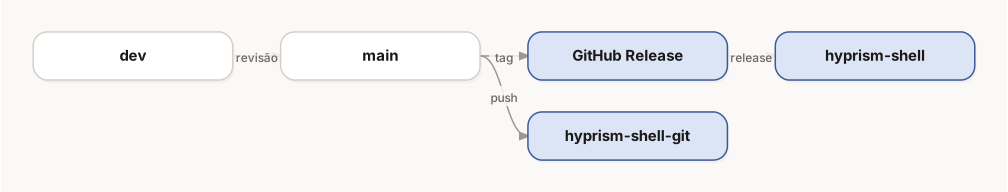
O workflow VCS roda em cada push para main e sincroniza hyprism-shell-git. O workflow estável reage à publicação de uma release, aceita execução manual e também roda periodicamente para corrigir alguma sincronização pendente. Ambos usam um container Arch Linux, criam um usuário sem privilégios para o build, preparam o acesso SSH e delegam a geração dos metadados ao mesmo script.
Automação adiciona outro ambiente ao projeto. Ele tem filesystem, usuário, credenciais, ferramentas e histórico Git próprios. A utilidade do CI está justamente em tornar essas condições explícitas, mas isso só funciona quando o processo automatizado já é compreendido o bastante para ser validado.
O repositório vira uma interface com usuários
O primeiro README do Hyprism não dizia nada. Pouco depois ele ganhou instruções de instalação e uma descrição da arquitetura. Durante a fase de rice, virou também uma apresentação visual com screenshots e vídeo. Quando outras pessoas começaram a instalar, passou a documentar requisitos, caminhos alterados, configuração, idiomas, CLI, atalhos, pacotes, troubleshooting e contribuição.
Essa mudança não é apenas crescimento de documentação. O papel do arquivo mudou. Enquanto o repositório servia para guardar meu ambiente, eu era a documentação. Depois que o projeto começou a circular, o README passou a ser o primeiro contato de alguém que não sabia quais decisões estavam embutidas no código.
Logo, banner e screenshots ajudaram a organizar essa entrada porque o Hyprism é visual. Isso não marcou uma transformação em produto “profissional”. Só tornou mais fácil entender o que o repositório contém antes de executar um instalador que gerencia uma parte considerável da sessão.
Os GitHub Issue Forms apareceram perto da primeira release pelo mesmo motivo. O formulário de bug pede passos de reprodução, comportamento esperado e observado, versões do Hyprism, Hyprland e Quickshell, distribuição e logs relevantes. O formulário de instalação pergunta qual operação falhou, se era uma instalação nova, update ou remoção e qual comando foi executado.
Esse tipo de estrutura parece burocracia quando o autor consegue reproduzir tudo olhando para a própria máquina. Com usuários externos, “o Wi-Fi não funciona” pode apontar para NetworkManager, backend Python, painel QML, permissão, versão antiga, distribuição não suportada ou um adaptador ausente do sistema. Sem contexto, uma issue informa que existe uma pessoa frustrada, mas oferece pouco material para diagnóstico.
Documentação, --help, mensagens de erro e templates de issue são partes da interface distribuída. Eles não implementam o shell, mas reduzem a quantidade de conhecimento privado necessária para instalar, operar e depurar o shell.
O que muda quando o código sai da própria máquina
O Hyprism continua sendo opinativo. Ele mira Arch Linux, assume uma sessão Hyprland atual e integra um conjunto específico de ferramentas. Torná-lo distribuível não significa remover todas as escolhas até sobrar um framework genérico. Significa saber quais escolhas definem o projeto e quais só estavam ali porque eu era o único usuário.
Uma forma prática de começar é procurar informações pessoais disfarçadas de configuração global. Nome de usuário, caminho, locale, shell, layout, monitor, hardware, aplicação padrão, serviço e gerenciador de pacotes merecem perguntas diferentes. Alguns são requisitos que precisam ser documentados. Outros podem ter defaults. Alguns devem ser detectados. Outros pertencem ao usuário e precisam sobreviver às atualizações.
Essa separação orienta a estrutura do software. No Hyprism, o arquivo distribuído contém defaults; ~/.config/hyprism/user.json contém o estado efetivo do usuário; o Hyprland fornece informações sobre os teclados presentes; a CLI valida e persiste overrides explícitos. Uma versão nova pode acrescentar uma opção sem tratar o arquivo anterior como descartável.
Instalação reproduzível vem antes de conveniência de instalação. O processo precisa verificar dependências, criar os diretórios corretos, preservar conflitos, inicializar estado, produzir erros compreensíveis e oferecer alguma forma de remoção. Só depois faz sentido codificá-lo num Makefile, num PKGBUILD ou num workflow. Empacotar um processo que ninguém entende apenas entrega uma falha misteriosa por um caminho mais curto.
O mesmo vale para a interface de configuração. Um arquivo editável é um bom escape para opções avançadas, mas tarefas comuns se beneficiam de comandos estáveis. Isso obriga o projeto a decidir quais valores aceita, como sinaliza erro, o que imprime e quando a mudança deve aparecer no processo em execução. Essas decisões acabam formando o contrato que updates futuros precisam respeitar.
Versões e pacotes entram quando há algo instalado fora do checkout do desenvolvedor. Tags permitem relacionar bug, documentação, tarball e checksum ao mesmo source. Canais estável e VCS atendem expectativas diferentes. Automação passa a ser útil quando consegue provar que a release, o tag, a receita e o repositório de distribuição estão falando sobre o mesmo estado.
Nada disso exige milhares de usuários. Escala aumenta a quantidade de combinações, a frequência dos relatos e o impacto das falhas, mas as categorias aparecem muito antes. Um projeto pequeno já precisa lidar com portabilidade, estado, compatibilidade, release engineering, autenticação e suporte assim que pessoas desconhecidas começam a depender dele.
Isso não torna a manutenção do Hyprism comparável à de Linux, GNOME, systemd ou uma distribuição inteira. O projeto continua pequeno, recente e imperfeito. O tamanho reduz a magnitude dos problemas. Não impede que eles sejam problemas reais.
A primeira prova de portabilidade
No meu notebook, teclado interno em ABNT2 e teclado externo em US International nunca foram um bug. Era exatamente a configuração que eu precisava. O bug apareceu quando essa informação pessoal chegou a outra máquina sem pedir licença.
Esse caso resume boa parte da passagem de uma solução pessoal para software distribuível. Código que vive num computador pode depender de fatos locais porque o autor conhece todos eles. Código que será instalado por outra pessoa precisa transformar esses fatos em requisito, detecção, default ou preferência. Se não fizer essa distinção, a máquina do desenvolvedor acaba funcionando como uma especificação acidental.
Projetos open source nem sempre começam com um plano de distribuição. Muitas vezes começam com uma pessoa resolvendo o próprio incômodo e outra perguntando se também pode usar a solução. A partir daí, o trabalho não é apenas publicar os arquivos. É permitir que o software sobreviva ao primeiro ambiente que o autor não controla.
No caso do Hyprism, essa primeira prova de portabilidade foi um teclado.