Docker: 'The Basics'
Uma introdução histórica e técnica ao Docker: o problema que ele resolveu, como imagens e containers funcionam e o que existe entre a CLI, o daemon, containerd, runc e o kernel Linux.
Docker é um daqueles assuntos difíceis de introduzir sem repetir alguma coisa que já foi explicada milhares de vezes.
A documentação oficial é boa. Existem cursos inteiros, livros, laboratórios interativos, vídeos de oito minutos e vídeos de oito horas. É possível aprender a baixar uma imagem, criar um Dockerfile, subir um container e colocar um docker compose up -d no currículo antes do almoço.
Por isso, este post não tem compromisso de ser o guia definitivo de Docker.
Ele é uma introdução e, ao mesmo tempo, uma nota pessoal sobre como eu uso Docker no dia a dia. Eu estava sem muita ideia do que escrever e achei que seria mais interessante comentar o assunto por uma perspectiva histórica e arquitetural, em vez de produzir mais um tutorial que começa com docker pull nginx, copia uma aplicação para dentro de uma imagem e termina fingindo que produção é só adicionar -d.
Os comandos básicos vão aparecer, porque seria estranho explicar Docker sem executar nada. Mas o objetivo principal é entender o que esses comandos pedem ao sistema.
Quando você digita docker run, quem recebe a solicitação? O que é criado? Onde a imagem fica? Por que o processo enxerga outro sistema de arquivos? O que impede um container de consumir toda a memória da máquina? Por que localhost para de significar aquilo que você esperava? O que realmente desaparece quando o container é removido?
Docker ficou popular porque tornou simples uma combinação de tecnologias que já existiam. A interface é amigável. O que existe abaixo dela não é exatamente simples.
E isso é justamente o que torna o assunto interessante.
O problema não era apenas executar software
Antes de falar sobre containers, vale lembrar qual problema Docker tentou resolver.
Executar um programa na própria máquina nunca foi a parte mais difícil do desenvolvimento. O problema começa quando o programa precisa executar em outra máquina, administrada por outra pessoa, com outro sistema, outras bibliotecas, outras versões e uma interpretação bastante criativa da palavra “configurado”.
A aplicação funciona no notebook do desenvolvedor porque ali existe a versão correta do runtime, a biblioteca nativa esperada, o arquivo de configuração esquecido, a variável de ambiente criada seis meses atrás e o diretório temporário que ninguém documentou.
No servidor, uma dessas peças está diferente.
Então surge a frase mais famosa da computação depois de “isso deveria funcionar”:
Na minha máquina funciona.
Docker nasceu dentro da dotCloud, uma empresa de Platform as a Service fundada por Solomon Hykes. O projeto foi demonstrado publicamente na PyCon de 2013 com uma formulação bastante direta do problema: enviar código para o servidor era difícil. A própria retrospectiva oficial do Docker resume a proposta como uma forma de padronizar a unidade usada para construir, distribuir e executar aplicações.
A ideia não era apenas isolar processos.
Era transformar a aplicação, suas dependências e parte importante de sua configuração em um artefato que pudesse circular entre desenvolvimento, teste e produção com menos variação.
Docker não eliminou diferenças de infraestrutura. CPU, kernel, armazenamento, rede, permissões e serviços externos continuam existindo. O que ele fez foi criar uma fronteira mais clara entre a aplicação e o ambiente que a executa.
Essa fronteira virou a imagem de container.
Docker não inventou containers
Docker popularizou containers, mas não inventou o conceito de isolar processos dentro de um sistema operacional.
Muito antes de 2013 já existiam mecanismos como chroot, FreeBSD Jails, Solaris Zones, OpenVZ e Linux Containers, o LXC. O próprio kernel Linux vinha acumulando as primitivas necessárias para isolamento e controle de recursos por meio de namespaces, control groups, capabilities e sistemas de arquivos com copy-on-write.
O mérito do Docker foi juntar essas peças em uma experiência coerente.
Em vez de pedir que cada equipe entendesse diretamente todos os detalhes de namespaces, mounts, cgroups, bridges, regras de firewall e sistemas de arquivos em camadas, Docker ofereceu uma CLI, uma API, um formato de imagem e um fluxo de distribuição.
No início, Docker utilizava LXC como uma das bases de execução. Em 2014, o projeto apresentou o libcontainer, uma implementação própria para interagir com os mecanismos do kernel. Com o amadurecimento do ecossistema, essa arquitetura foi sendo dividida em componentes menores. O runtime de baixo nível evoluiu para o runc, e o gerenciamento de ciclo de vida foi separado no containerd.
Essa modularização não foi apenas organização interna.
Em 2015, Docker, CoreOS e outras empresas participaram da criação da Open Container Initiative, a OCI, para padronizar formatos de imagem, runtimes e distribuição. Isso permitiu que uma imagem deixasse de ser exclusivamente “uma imagem do Docker” e passasse a participar de um ecossistema com especificações abertas.
Hoje, ferramentas diferentes conseguem construir, armazenar, distribuir e executar imagens compatíveis com OCI.
Docker continua sendo a interface mais reconhecida desse mundo, mas container não é sinônimo técnico de Docker.
Da mesma forma que GitHub não é Git, Docker Hub não é container e Kubernetes não é Docker com mais YAML.
Então o que é Docker?
A palavra Docker pode representar coisas diferentes dependendo da conversa.
Pode significar a empresa Docker. Pode significar Docker Desktop. Pode significar Docker Engine. Pode significar a CLI docker. Também pode ser usada de maneira genérica para falar de containers, mesmo quando nenhum componente do Docker participa da execução.
Neste post, o foco principal é o Docker Engine e as ferramentas em torno dele.
A documentação oficial descreve Docker como uma plataforma aberta para desenvolver, distribuir e executar aplicações. A arquitetura básica segue um modelo cliente-servidor.
Quando você executa:
docker ps
o binário docker não sai sozinho procurando processos isolados pelo sistema.
Ele atua como cliente.
A CLI envia uma requisição para a API do Docker Engine. Normalmente, em Linux, essa comunicação ocorre por um socket Unix:
/var/run/docker.sock
Do outro lado está o daemon:
dockerd
O daemon administra objetos como containers, imagens, redes e volumes. Ele conversa com outros componentes para baixar conteúdo, preparar sistemas de arquivos e iniciar processos.
Uma visão simplificada da arquitetura fica assim:
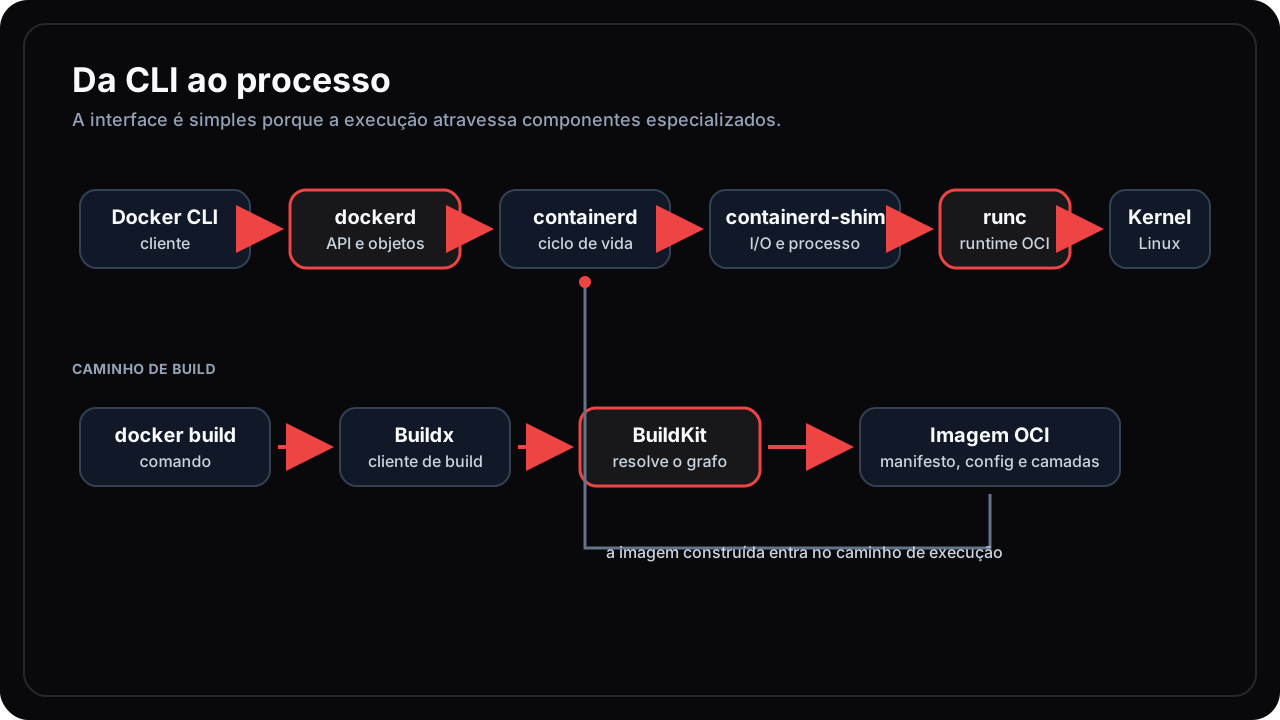
A interface unifica dois caminhos relacionados: a construção produz imagens OCI, enquanto a execução transforma essas imagens em processos isolados pelo kernel.
A documentação de build explica que Buildx funciona como cliente e BuildKit como o backend responsável por resolver e executar as etapas de construção.
Isso já desmonta uma ideia comum.
Docker não é um único binário monolítico que faz tudo. A experiência parece unificada, mas o sistema é composto por várias peças com responsabilidades diferentes.
Container não é uma máquina virtual pequena
A comparação com máquinas virtuais ajuda no começo, mas atrapalha quando é levada longe demais.
Uma máquina virtual simula ou virtualiza hardware suficiente para executar outro sistema operacional. Ela possui seu próprio kernel, seus próprios processos e uma fronteira de isolamento construída pelo hypervisor.
Um container Linux é, em essência, um processo Linux isolado e limitado por mecanismos do kernel.
A frase é simples, mas precisa ser levada a sério:
Container é processo.
Ele pode enxergar um sistema de arquivos próprio, uma pilha de rede própria, uma árvore de processos própria e limites próprios de memória e CPU. Ainda assim, o código executa como processo do kernel do host.
Se você listar os processos na máquina hospedeira, encontrará os processos dos containers.
O processo pode acreditar que é o PID 1 dentro do próprio namespace e, ao mesmo tempo, possuir outro PID visto pelo host.
Ele não traz um kernel Linux inteiro dentro da imagem.
É por isso que uma imagem Linux não funciona diretamente sobre qualquer kernel arbitrário. Ela depende das interfaces oferecidas pelo kernel Linux e da arquitetura de CPU compatível.
Também é por isso que uma falha no kernel pode atravessar uma fronteira que seria diferente em uma máquina virtual. Containers compartilham o kernel do host.
Isolamento não é virtualização completa.
Não existe um objeto mágico chamado container no kernel
O kernel Linux não possui uma chamada como:
create_container();
O que chamamos de container é uma composição de recursos já existentes.
O runtime cria um processo, configura namespaces, associa esse processo a cgroups, aplica capabilities, prepara mounts, define regras de segurança e executa o programa indicado pela imagem.
O resultado dessa composição recebe o nome de container.
Essa definição é importante porque explica por que diferentes runtimes conseguem executar containers. Eles podem implementar a mesma especificação e produzir uma combinação equivalente de isolamento, sistema de arquivos e configuração.
A especificação de runtime da OCI descreve como um bundle deve ser executado. O runc é uma implementação dessa especificação.
Docker fornece a experiência de alto nível. runc lida com a parte mais próxima do kernel.
Entre os dois existe bastante trabalho.
Namespaces: cada processo enxerga seu próprio mundo
Namespaces são uma das principais bases do isolamento de containers.
Eles fazem um processo enxergar uma visão específica de determinado recurso do sistema.
Um PID namespace cria uma árvore de processos separada. Um network namespace fornece interfaces, rotas e regras de rede próprias. Um mount namespace controla quais sistemas de arquivos e mounts são visíveis. Um UTS namespace separa hostname e domain name.
Os principais namespaces envolvidos em containers Linux incluem:
| Namespace | O que separa |
|---|---|
| PID | Árvore e numeração de processos |
| Mount | Pontos de montagem e visão do sistema de arquivos |
| Network | Interfaces, endereços, rotas e portas |
| UTS | Hostname e nome de domínio |
| IPC | Recursos de comunicação entre processos |
| User | IDs de usuários e grupos |
| Cgroup | Visão da hierarquia de cgroups |
| Time | Determinados relógios do sistema |
Imagine um processo dentro de um container executando:
ps aux
Ele pode ver apenas os processos do próprio PID namespace.
Ao executar:
hostname
ele pode receber um nome diferente do host.
Ao listar interfaces de rede:
ip addr
ele enxerga interfaces criadas para aquele namespace, não necessariamente todas as interfaces físicas da máquina.
Isso não significa que os recursos deixaram de existir no host. Significa que o kernel apresenta uma visão restrita para aquele conjunto de processos.
Namespace controla visibilidade.
Ele não controla sozinho quanto recurso o processo pode consumir.
Para isso entram os cgroups.
Cgroups: isolamento sem limite ainda pode derrubar o host
Control groups, ou cgroups, organizam processos em grupos aos quais o kernel pode aplicar contabilidade e limites de recursos.
Eles permitem controlar ou observar consumo de memória, CPU, quantidade de processos e outros recursos.
Por padrão, um container Docker pode não possuir limites rígidos de CPU e memória. A própria documentação de restrições de recursos alerta que, sem configuração, o container pode utilizar tanto recurso quanto o scheduler do host permitir.
Isso significa que “está em container” não impede uma aplicação com memory leak de consumir a memória da máquina.
Um exemplo com limites explícitos:
docker run \
  --name worker \
  --memory 512m \
  --cpus 1.5 \
  --pids-limit 200 \
  minha-imagem:1.0
--memory 512m define um limite de memória.
--cpus 1.5 limita o tempo de CPU a uma quantidade equivalente a um núcleo e meio.
--pids-limit 200 restringe a quantidade de processos que podem existir no container.
Por baixo, Docker traduz essas opções para configurações de cgroup.
Isso também explica o funcionamento de:
docker stats
O comando não está adivinhando o consumo da aplicação. Ele consulta métricas associadas aos cgroups e aos processos do container.
Namespace responde “o que o processo enxerga?”.
Cgroup responde “quanto o processo pode usar?”.
São problemas diferentes.
Capabilities, seccomp e as outras camadas
O usuário root tradicional do Unix possui um conjunto enorme de privilégios.
Linux capabilities dividem parte desses poderes em unidades menores. Em vez de entregar tudo ou nada, o kernel consegue conceder capacidades específicas, como alterar configurações de rede, trocar IDs de usuário ou administrar determinadas operações do sistema.
Docker remove algumas capabilities por padrão e permite adicionar ou retirar outras:
docker run \
  --cap-drop ALL \
  --cap-add NET_BIND_SERVICE \
  minha-imagem:1.0
Nesse exemplo, todas as capabilities são removidas e apenas a necessária para determinadas operações de bind é adicionada novamente.
Docker também utiliza seccomp. O perfil padrão de seccomp restringe chamadas de sistema consideradas desnecessárias ou perigosas para a maioria dos workloads.
Além disso, mecanismos como AppArmor e SELinux podem aplicar políticas adicionais sobre o que os processos conseguem acessar.
Uma visão mais honesta do isolamento fica assim:
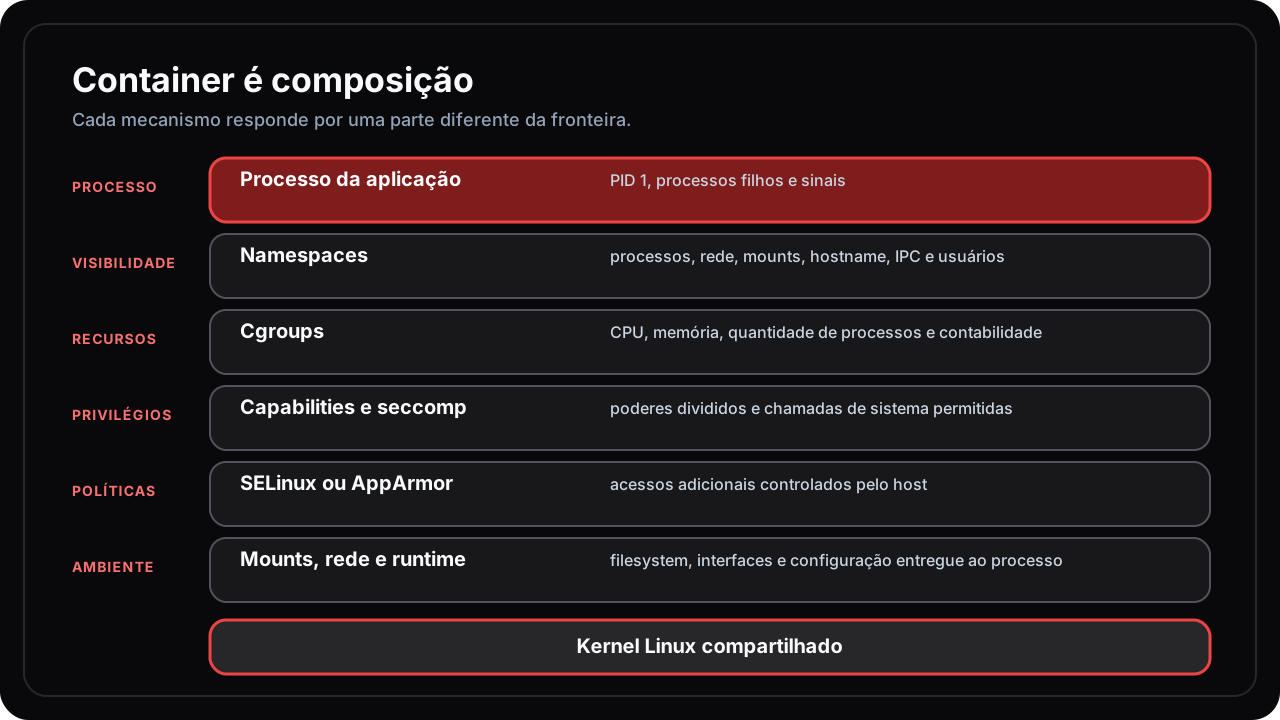
O container nasce da combinação de várias primitivas. Nenhuma delas, isoladamente, representa toda a fronteira de segurança.
Nenhuma camada é perfeita isoladamente.
E existe uma opção capaz de abrir mão de boa parte dessa prudência:
--privileged
Container privilegiado recebe acesso muito mais amplo a dispositivos e capabilities. Ele não vira literalmente o host, mas a fronteira fica dramaticamente mais fraca.
--privileged não deveria ser o equivalente de Docker a “executar como administrador para ver se funciona”.
Quando essa flag resolve um problema, a pergunta seguinte deveria ser qual permissão específica estava faltando.
O daemon é uma parte sensível da segurança
Em uma instalação tradicional, dockerd executa com privilégios elevados porque precisa criar namespaces, configurar rede, montar sistemas de arquivos e administrar recursos do host.
Por isso, acesso ao socket do Docker é extremamente poderoso.
Um usuário capaz de enviar comandos para:
/var/run/docker.sock
pode, por exemplo, iniciar um container com o sistema de arquivos do host montado e executar comandos sobre ele.
Na prática, acesso irrestrito ao daemon costuma ser equivalente a acesso root na máquina.
Isso também vale quando alguém monta o socket dentro de outro container:
volumes:
  - /var/run/docker.sock:/var/run/docker.sock
Esse padrão aparece em painéis, agentes de CI, atualizadores automáticos e ferramentas de observabilidade. Às vezes existe uma justificativa real. Ainda assim, o container deixa de ser apenas uma aplicação isolada e passa a controlar o daemon do host.
O Docker oferece rootless mode, no qual daemon e containers executam sem privilégios root tradicionais, usando user namespaces. Isso reduz parte do impacto de vulnerabilidades, embora traga limitações e diferenças operacionais.
Segurança de container não começa no Dockerfile.
Ela começa em quem controla o runtime.
Da CLI até o kernel
Agora podemos voltar à arquitetura e abrir melhor cada camada.
O fluxo moderno, de forma simplificada, envolve estes componentes:
| Componente | Responsabilidade principal |
|---|---|
docker | Interface de linha de comando e cliente da API |
dockerd | Gerenciamento de alto nível de imagens, containers, redes e volumes |
| containerd | Ciclo de vida, conteúdo, snapshots e tarefas de containers |
| containerd-shim | Mantém integração com o processo, I/O e ciclo de vida sem prender tudo ao daemon |
| runc | Cria e inicia o container segundo a especificação OCI |
| kernel | Fornece namespaces, cgroups, mounts, rede e execução dos processos |
A documentação de runtimes alternativos confirma que Docker Engine utiliza containerd para administrar o ciclo de vida e, por padrão, containerd utiliza runc como runtime.
runc é chamado para preparar e iniciar o processo com a configuração necessária. Ele não precisa permanecer como um daemon pesado para cada container durante toda a execução.
O shim ajuda a desacoplar o processo em execução do containerd. Ele mantém aspectos como I/O, status e coleta do processo filho. Isso permite que componentes superiores sejam reiniciados ou atualizados sem que cada processo de aplicação dependa diretamente de uma conexão permanente com eles.
A arquitetura real possui mais detalhes, plugins e caminhos alternativos. Ainda assim, esse modelo já é suficiente para interpretar muitos erros.
Quando uma mensagem diz:
OCI runtime create failed
o problema provavelmente aconteceu perto da preparação de baixo nível do processo.
Quando o erro menciona BuildKit, ele está no caminho de construção.
Quando o daemon não responde, a CLI talvez nem tenha chegado perto de criar um namespace.
Mensagens de Docker parecem menos místicas quando você sabe qual componente estava trabalhando.
O que realmente acontece em docker run
Considere este comando:
docker run \
  --name web \
  -d \
  -p 127.0.0.1:8080:80 \
  --restart unless-stopped \
  nginx:alpine
Ele parece uma única operação, mas representa várias decisões.
docker run é, conceitualmente, uma combinação de criação e início:
docker create + docker start
Se a imagem nginx:alpine não estiver disponível localmente, o daemon procura o conteúdo no registry configurado e baixa as camadas necessárias.
Depois, Docker cria a configuração do container. Isso inclui nome, imagem, comando, variáveis, mounts, rede, política de reinício e outras opções.
Uma camada gravável é preparada sobre as camadas somente leitura da imagem.
Um endpoint de rede é criado e conectado à rede escolhida. Como não especificamos outra, será usada a rede padrão aplicável.
A porta 8080 do loopback do host é mapeada para a porta 80 do container.
O runtime prepara namespaces, cgroups, mounts e políticas de segurança.
O processo principal da imagem é iniciado.
A opção -d apenas deixa o container em modo detached. Ela não transforma o processo em serviço, não adiciona alta disponibilidade e não cria monitoramento.
--restart unless-stopped define uma política para que o daemon tente reiniciar o container após determinadas saídas ou reinicializações, exceto quando ele foi explicitamente parado.
--name web cria um nome humano. Sem isso, Docker gera algo mais divertido do que útil para operação.
O endereço explícito em:
127.0.0.1:8080:80
faz a publicação apenas no loopback do host. Sem o 127.0.0.1, Docker normalmente publica em todas as interfaces:
-p 8080:80
Isso pode tornar o serviço acessível pela rede e, em uma VPS, pela internet.
A parte mais importante do comando talvez seja justamente a que quase sempre é omitida nos tutoriais.
Imagem não é container
Imagem é um artefato somente leitura que descreve o sistema de arquivos e a configuração padrão necessária para executar uma aplicação.
Container é uma instância criada a partir dessa imagem, com uma configuração concreta e uma camada gravável própria.
A relação lembra classe e objeto apenas até certo ponto. Também lembra executável e processo apenas até certo ponto.
O modelo mais útil é:
imagem + configuração de runtime + camada gravável = container
Vários containers podem compartilhar as mesmas camadas de imagem sem compartilhar a camada gravável.
Se você iniciar três containers Nginx a partir da mesma imagem, Docker não precisa manter três cópias completas de todo o conteúdo base. As camadas somente leitura podem ser reutilizadas.
Cada container recebe seu próprio estado temporário por cima delas.
É essa combinação de compartilhamento e isolamento que torna o modelo eficiente.
Imagens são conjuntos de conteúdo, não discos congelados
Uma imagem OCI é formada por manifestos, configuração e camadas de sistema de arquivos.
As camadas normalmente representam diferenças produzidas durante o build. Elas são distribuídas como conteúdo identificável por digest.
Quando você executa:
docker pull nginx:alpine
a tag nginx:alpine ajuda a localizar um manifesto.
As camadas referenciadas são baixadas e verificadas por seus digests.
O digest costuma aparecer no formato:
sha256:...
Esse identificador é derivado do conteúdo. Se o conteúdo muda, o digest muda.
Uma tag funciona mais como um ponteiro amigável.
nginx:alpine pode apontar hoje para um conjunto de bytes e, no futuro, para outro. O mesmo vale para latest, que não possui qualquer propriedade especial além de ser uma tag usada como padrão em alguns fluxos.
Para fixar exatamente um artefato, é possível referenciar o digest:
nginx@sha256:...
Tags ajudam humanos e fluxos de release.
Digests identificam conteúdo.
Confundir os dois é uma ótima maneira de descobrir que “a mesma versão” não era exatamente a mesma.
Camadas e copy-on-write
Cada etapa relevante de uma construção pode produzir uma nova camada.
Considere:
FROM node:24-alpine

WORKDIR /app

COPY package.json package-lock.json ./

RUN npm ci

COPY . .

CMD ["node", "server.js"]
A imagem base já contém suas próprias camadas.
O COPY dos arquivos de dependência adiciona mudanças.
RUN npm ci adiciona o resultado da instalação.
O segundo COPY adiciona o restante do projeto.
Na execução, Docker monta essas camadas como uma visão única e coloca uma camada gravável no topo.
A documentação de storage drivers explica esse modelo por copy-on-write. Enquanto um arquivo existente só precisa ser lido, ele pode continuar vindo de uma camada inferior. Quando precisa ser alterado, o sistema realiza uma cópia para a camada gravável e modifica essa cópia.
Em implementações baseadas em OverlayFS, essa operação é frequentemente chamada de copy_up.
Isso economiza espaço, mas não significa que escrever na camada do container seja sempre a melhor opção.
Bancos de dados, filas persistentes e workloads com muito I/O não deveriam depender dessa camada como armazenamento principal.
Além da persistência frágil, existe custo adicional em determinados padrões de escrita.
A imagem é base.
A camada gravável é estado efêmero da instância.
Dados importantes merecem outro lugar.
Apagar em outra camada não apaga da história
Camadas também produzem um problema menos óbvio.
Considere este Dockerfile ruim:
FROM alpine

COPY segredo.txt /tmp/segredo.txt

RUN usar-o-segredo /tmp/segredo.txt

RUN rm /tmp/segredo.txt
Na visão final do sistema de arquivos, o arquivo pode parecer removido.
Mas ele foi adicionado em uma camada anterior. A camada posterior registra a remoção, não reescreve retroativamente a história.
Quem obtiver as camadas pode recuperar o conteúdo original.
O mesmo problema aparece quando tokens, chaves privadas, arquivos .env ou credenciais entram no build context.
Remover depois não é suficiente.
BuildKit oferece mounts de secret próprios para build, que disponibilizam o segredo durante uma etapa sem incorporá-lo à camada final. Um .dockerignore bem feito também evita enviar arquivos desnecessários para o builder.
Container image não é uma caixa preta.
Ela é um conjunto de artefatos inspecionáveis.
O ponto no final de docker build não é decoração
Este comando aparece em quase todo tutorial:
docker build -t minha-api:1.0 .
O ponto final representa o build context.
Ele informa qual conjunto de arquivos pode ser acessado pelo build.
O Dockerfile não possui acesso mágico ao computador inteiro. Instruções como COPY leem arquivos do contexto enviado ao builder.
Se o contexto é a raiz de um monorepo com gigabytes de artefatos, caches, dependências e arquivos privados, você aumentou o trabalho e a superfície de erro.
Um .dockerignore pode remover do contexto itens como:
.git
node_modules
dist
.env
coverage
*.log
A ordem das instruções também importa para cache.
No exemplo anterior, copiamos package.json e package-lock.json antes do restante do código. Assim, uma mudança em server.js não invalida automaticamente a etapa de instalação das dependências.
Se fizéssemos:
COPY . .
RUN npm ci
qualquer alteração no projeto poderia invalidar a camada anterior e executar npm ci novamente.
Build cache não é apenas uma otimização escondida.
A estrutura do Dockerfile define o grafo de trabalho que o builder consegue reutilizar.
Multi-stage builds e a separação entre construir e executar
Muitas aplicações precisam de ferramentas pesadas para serem construídas, mas não para executar.
Um projeto Go precisa do compilador durante o build. O binário final pode não precisar de toda a toolchain.
Um frontend precisa de Node.js para gerar arquivos estáticos. O servidor final pode precisar apenas de Nginx.
Multi-stage builds separam essas etapas:
FROM golang:1.25-alpine AS builder

WORKDIR /src

COPY go.mod go.sum ./
RUN go mod download

COPY . .
RUN CGO_ENABLED=0 go build -o /out/api ./cmd/api

FROM alpine:3.22

RUN addgroup -S app && adduser -S app -G app

COPY --from=builder /out/api /usr/local/bin/api

USER app

ENTRYPOINT ["/usr/local/bin/api"]
A primeira etapa contém compilador e dependências de build.
A segunda recebe apenas o artefato necessário.
Isso reduz tamanho, superfície de ataque e quantidade de componentes enviados para produção.
Imagem pequena não é automaticamente segura. Ainda assim, remover ferramentas desnecessárias é uma boa forma de reduzir o que pode quebrar ou ser explorado.
Também torna mais clara uma separação importante:
O ambiente que produz o programa não precisa ser o mesmo ambiente que executa o programa.
CMD, ENTRYPOINT e o processo principal
Todo container precisa de um processo principal.
Ele vem da combinação de ENTRYPOINT, CMD e argumentos fornecidos no docker run.
Uma configuração comum:
ENTRYPOINT ["/usr/local/bin/api"]
CMD ["serve", "--port", "8080"]
Nesse caso, ENTRYPOINT define o executável principal e CMD fornece argumentos padrão.
Ao executar:
docker run minha-api:1.0
o resultado é equivalente a:
/usr/local/bin/api serve --port 8080
Se o usuário executar:
docker run minha-api:1.0 migrate
o CMD padrão é substituído e o resultado pode ser:
/usr/local/bin/api migrate
Existe uma diferença importante entre forma shell e forma exec.
Forma shell:
CMD node server.js
Forma exec:
CMD ["node", "server.js"]
Na forma shell, o comando passa normalmente por:
/bin/sh -c
Isso pode fazer o shell virar PID 1 e interferir no encaminhamento de sinais.
A referência de Dockerfile recomenda atenção a esse comportamento porque o processo real pode deixar de receber corretamente o SIGTERM enviado durante o encerramento.
Para serviços, a forma exec costuma produzir um ciclo de vida mais previsível.
PID 1 não é um processo comum
Dentro do PID namespace, o processo principal do container normalmente recebe PID 1.
No Linux, PID 1 possui responsabilidades e comportamentos especiais.
Ele precisa lidar adequadamente com sinais e coletar processos filhos encerrados. Quando um processo filho termina e o pai não executa a coleta necessária, pode restar um processo zumbi.
Aplicações escritas sem considerar esse papel podem funcionar normalmente fora de um container e se comportar mal como PID 1.
Docker oferece:
docker run --init minha-imagem:1.0
A opção --init insere um pequeno processo init responsável por encaminhar sinais e coletar filhos. A documentação sobre múltiplos processos explica esse uso.
Isso não significa que todo container precisa executar systemd.
Também não significa que “um processo por container” seja uma lei física.
Um servidor pode criar vários workers. Uma aplicação pode iniciar processos auxiliares. A recomendação mais útil é manter uma responsabilidade principal por container e garantir que o processo principal administre corretamente o próprio ciclo de vida.
Container não para porque Docker sentiu que a aplicação terminou.
Ele para quando o processo principal termina.
docker stop não começa com força bruta
Quando você executa:
docker stop web
Docker envia um sinal de encerramento ao processo principal.
Por padrão, a documentação de docker stop descreve o envio de SIGTERM. Depois de um período de tolerância, se o processo não terminar, Docker envia SIGKILL.
Esse comportamento existe para permitir graceful shutdown.
Uma API pode parar de aceitar novas conexões, concluir requisições em andamento, fechar o pool do banco e gravar buffers antes de sair.
Se o processo principal não recebe o sinal porque existe um shell mal configurado na frente, ou ignora o encerramento, ele será morto ao fim do prazo.
É possível alterar o sinal com STOPSIGNAL no Dockerfile ou opções de runtime, mas a aplicação ainda precisa implementar o comportamento correto.
Reinício rápido não substitui encerramento correto.
Especialmente quando há estado, filas, locks e conexões abertas.
docker exec não entra em uma máquina
Este comando é muito usado:
docker exec -it web sh
A descrição popular é “entrar no container”.
Ela funciona como metáfora, mas tecnicamente o Docker está iniciando outro processo dentro do contexto do container existente.
O novo processo passa a usar namespaces, cgroups e parte da configuração daquele container.
Ele não abre uma sessão em uma VM.
Ele também depende do processo principal continuar em execução. A documentação de docker exec observa que o comando executado existe apenas enquanto o processo principal do container está vivo.
As opções significam:
-i mantém a entrada padrão aberta.
-t aloca um pseudo-terminal.
sh é o programa iniciado.
Se a imagem não possui shell, o comando falha. Imagens mínimas e distroless frequentemente não incluem sh, bash, ps, curl ou um gerenciador de pacotes.
Isso é ótimo para reduzir superfície.
Também transforma debug improvisado em uma experiência filosófica.
attach não é exec
docker attach conecta seu terminal ao processo principal já existente.
docker exec cria outro processo.
A diferença importa.
Ao usar:
docker attach web
você vê a entrada e saída do ENTRYPOINT ou CMD principal. Dependendo da aplicação e das teclas enviadas, pode afetar diretamente o processo.
Ao usar:
docker exec -it web sh
você inicia um shell separado.
Para diagnóstico, exec costuma ser menos invasivo.
Para observar a saída principal, normalmente docker logs é mais apropriado.
E para produção, depender de abrir shell dentro do container como principal estratégia de operação costuma ser um sinal de que observabilidade ainda está sendo tratada como decoração.
Logs são stdout e stderr, não telepatia
docker logs não procura automaticamente todos os arquivos .log dentro do container.
Por padrão, ele trabalha com a saída padrão e a saída de erro do processo, conforme o logging driver configurado.
A documentação de logs explica que aplicações devem direcionar saída relevante para STDOUT e STDERR quando querem integração natural com o mecanismo de logging.
Por isso, imagens oficiais como Nginx redirecionam logs tradicionais para esses streams.
Exemplo:
docker logs web
Acompanhar continuamente:
docker logs -f web
Mostrar as últimas cem linhas:
docker logs --tail 100 web
Adicionar timestamps:
docker logs -t web
O driver padrão tradicional é json-file, que armazena registros em arquivos administrados pelo daemon. Sem rotação, logs podem consumir disco. A documentação de logging drivers sugere considerar o driver local para reduzir risco de esgotamento por armazenamento.
Não leia ou edite diretamente os arquivos internos do driver.
Eles pertencem ao daemon.
Se a estratégia de logs depende de entrar no container e executar tail -f /var/log/app.log, ela funciona até o momento em que você precisa investigar cinquenta instâncias distribuídas em vários nós.
Estado running não significa aplicação saudável
Docker considera um container em execução enquanto o processo principal está vivo.
Isso não prova que a aplicação está funcional.
Uma API pode ter travado internamente, perdido conexão com o banco ou parado de responder HTTP sem encerrar o processo.
HEALTHCHECK adiciona um estado de saúde separado:
HEALTHCHECK \
  --interval=30s \
  --timeout=3s \
  --start-period=10s \
  --retries=3 \
  CMD wget -qO- http://127.0.0.1:8080/health || exit 1
O container pode estar:
running, healthy
ou:
running, unhealthy
Isso ajuda ferramentas superiores a interpretar o estado.
Ainda assim, healthcheck precisa ser desenhado com cuidado. Um teste superficial pode dizer que tudo está bem enquanto dependências críticas falharam. Um teste pesado pode sobrecarregar a própria aplicação. Um teste que depende de todos os serviços externos pode transformar uma falha parcial em cascata.
Saúde não é uma URL escolhida no fim do projeto.
É uma definição operacional.
Os comandos básicos como ciclo de vida
Depois de entender a arquitetura, os comandos mais comuns ficam menos arbitrários.
Ver versões do cliente e servidor:
docker version
Ver configuração e capacidades do daemon:
docker info
Baixar uma imagem:
docker pull nginx:alpine
Listar imagens:
docker image ls
Criar e iniciar um container:
docker run --name web -d nginx:alpine
Listar containers em execução:
docker ps
Listar também os parados:
docker ps -a
Inspecionar a configuração completa:
docker inspect web
Ver logs:
docker logs -f web
Executar outro processo:
docker exec -it web sh
Observar recursos:
docker stats web
Parar:
docker stop web
Iniciar novamente o mesmo container:
docker start web
Remover:
docker rm web
Remover a imagem:
docker image rm nginx:alpine
A distinção entre start e run é importante.
docker start inicia um container que já existe com a configuração que ele possuía.
Ele não reaplica novas portas, variáveis ou mounts digitados em outro comando.
Para mudar grande parte da configuração, você recria o container.
Isso parece descartável porque é exatamente a ideia.
Containers devem ser fáceis de substituir.
Dados importantes não.
A camada gravável não é armazenamento permanente
Todo container possui uma camada gravável sobre a imagem.
Se a aplicação criar:
/app/uploads/foto.png
sem um mount externo, o arquivo vai para a camada daquela instância.
Ao remover o container, essa camada é removida.
Outro container criado da mesma imagem não recebe automaticamente o arquivo.
Isso surpreende quem pensa que a imagem foi modificada durante a execução.
Ela não foi.
O container apenas acumulou diferenças locais.
Para persistência, Docker oferece mounts que vivem fora dessa camada.
Os três modelos mais comuns são volumes, bind mounts e tmpfs.
| Tipo | Onde o dado vive | Uso comum |
|---|---|---|
| Volume | Área administrada pelo Docker | Banco, uploads e dados persistentes |
| Bind mount | Caminho explícito do host | Código fonte e configurações locais |
| tmpfs | Memória do host | Dados temporários e sensíveis |
A documentação de storage separa claramente o armazenamento interno de camadas do armazenamento persistente montado no container.
Essa divisão evita um erro clássico:
Container é descartável, então os dados também devem ser.
Não.
A infraestrutura da aplicação deve conseguir substituir a instância sem perder o estado que precisa sobreviver.
Volumes
Um volume é um armazenamento administrado pelo Docker.
Criar:
docker volume create dados-postgres
Listar:
docker volume ls
Inspecionar:
docker volume inspect dados-postgres
Montar:
docker run \
  --name banco \
  --mount type=volume,src=dados-postgres,dst=/var/lib/postgresql/data \
  postgres:17-alpine
O volume possui ciclo de vida separado do container.
Remover o container não remove automaticamente um volume nomeado.
Isso permite recriar a aplicação e remontar os mesmos dados.
Também significa que:
docker rm banco
não é backup.
Se o volume for corrompido, apagado ou perdido com o disco do host, os dados continuam perdidos.
A documentação de volumes recomenda volumes para dados persistentes e workloads que precisam de I/O sem depender da camada copy-on-write.
Docker administra o caminho, mas a responsabilidade por backup, restore e consistência ainda é sua.
Infraestrutura abstraída continua obedecendo às leis da física e da negligência.
Bind mounts
Bind mount conecta um caminho do host diretamente a um caminho do container:
docker run \
  --name app \
  --mount type=bind,src="$(pwd)",dst=/workspace \
  node:24-alpine
O diretório atual do host aparece como /workspace no container.
Isso é muito útil em desenvolvimento porque o editor modifica arquivos no host e o processo no container enxerga essas alterações.
Também cria acoplamento.
O caminho precisa existir no host. Permissões e ownership precisam ser compatíveis. O container pode modificar os arquivos do host quando o mount é gravável.
Montar algo como:
/:/host
entrega ao container uma visão ampla do sistema.
A documentação de bind mounts alerta que processos no container podem criar, alterar ou remover arquivos do host.
Quando a aplicação só precisa ler, use somente leitura:
docker run \
  --mount type=bind,src="$(pwd)/config.yml",dst=/app/config.yml,readonly \
  minha-imagem:1.0
Bind mounts são excelentes para código e integração local.
Volumes costumam ser mais adequados quando o dado pertence ao serviço, não ao desenvolvedor.
Mounts escondem o conteúdo anterior
Um detalhe que confunde bastante: montar um volume ou bind mount sobre um diretório não vazio esconde o conteúdo anterior daquele caminho.
Imagine que a imagem contém:
/app/config/default.yml
Se você monta um diretório vazio do host em /app/config, o arquivo deixa de aparecer para o processo.
Ele não foi apagado da imagem.
O novo mount apenas ficou por cima daquela parte do sistema de arquivos.
O comportamento é semelhante a montar um disco sobre um diretório Linux que já possuía arquivos.
Isso explica vários casos em que “o volume apagou os arquivos da imagem”.
Ele não apagou.
Ele escondeu.
Para recuperar a visão original, recrie o container sem aquele mount.
UID e GID atravessam a abstração
Arquivos em Linux pertencem a IDs numéricos de usuário e grupo.
Dentro de um container, o usuário app pode possuir UID 1000. No host, UID 1000 pode representar seu usuário local.
Se o processo executa como root no container e escreve em um bind mount, arquivos podem aparecer no host pertencendo a root.
Isso não é um bug de Docker.
É o kernel aplicando ownership numérico sobre o mesmo sistema de arquivos.
User namespaces e rootless mode podem alterar o mapeamento, mas o problema básico continua importante em desenvolvimento e CI.
Quando um container gera arquivos no projeto, vale verificar com qual UID ele executa.
Adicionar:
USER app
não serve apenas para segurança. Também ajuda a evitar que cada build local deixe um pequeno monumento a sudo chown -R.
tmpfs
Um tmpfs mount mantém o conteúdo em memória:
docker run \
  --mount type=tmpfs,dst=/tmp/runtime \
  minha-imagem:1.0
Ele é útil para caches temporários, dados que não precisam persistir e determinados segredos em runtime.
O conteúdo desaparece quando o container para ou quando a máquina reinicia.
Como está em memória, tmpfs também consome recurso real do host.
“Não está no disco” não significa “não custa nada”.
E dados sensíveis em tmpfs ainda podem aparecer na memória, em dumps ou por acesso indevido do processo. É uma redução de persistência, não uma magia criptográfica.
A rede começa com outro namespace
Por padrão, containers possuem seu próprio network namespace.
Docker pode criar uma interface virtual para o container, conectá-la a uma bridge no host, atribuir um IP e configurar roteamento.
Uma representação simplificada:
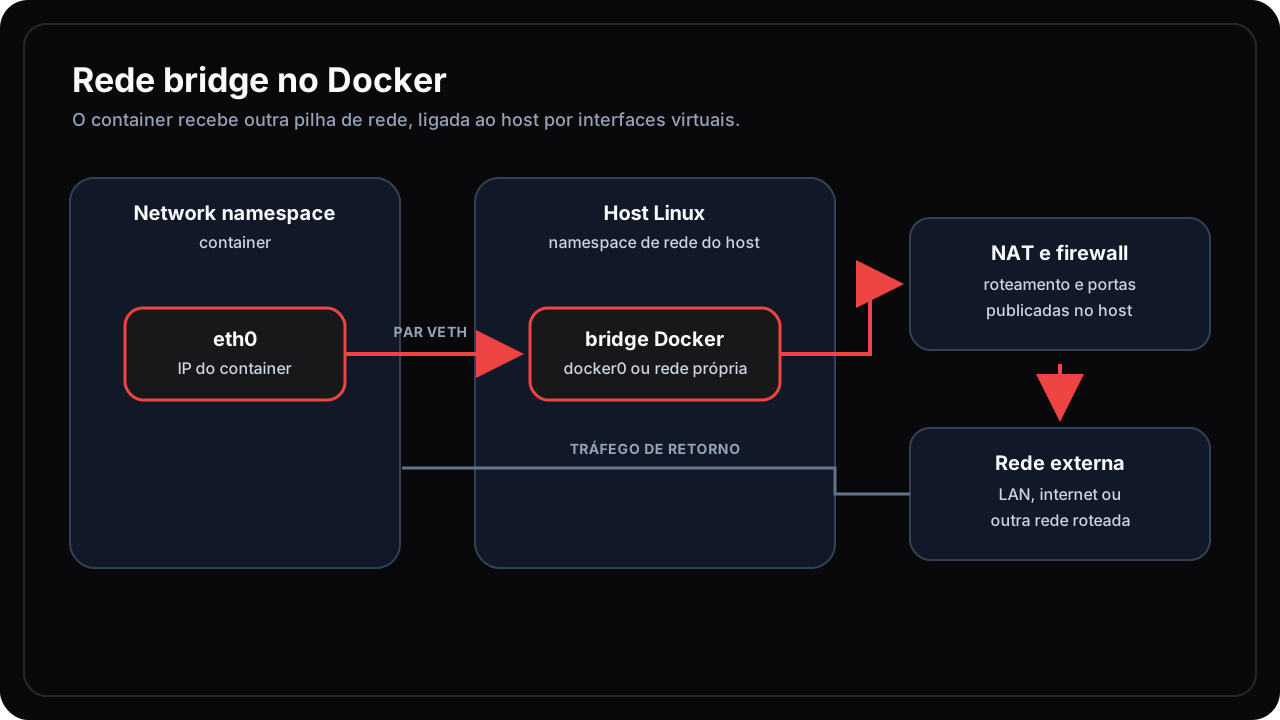
A interface eth0 do container e a bridge do host são ligadas por um par virtual. Publicação de portas e saída para outras redes dependem do roteamento e das regras aplicadas no host.
A interface vista dentro do container é uma ponta de um par virtual. A outra ponta existe no host e se conecta à bridge.
A rede bridge é o driver padrão para muitos containers locais. A documentação do driver bridge recomenda redes definidas pelo usuário porque elas oferecem melhor isolamento e descoberta por nome.
Criar uma rede:
docker network create app-net
Iniciar um banco:
docker run \
  --name db \
  --network app-net \
  -e POSTGRES_PASSWORD=exemplo \
  postgres:17-alpine
Iniciar uma aplicação na mesma rede:
docker run \
  --name api \
  --network app-net \
  -e DATABASE_HOST=db \
  minha-api:1.0
A aplicação pode usar db como hostname.
Ela não precisa conhecer o IP atual do container.
IPs são detalhes de implementação e podem mudar quando a instância é recriada.
Nomes de serviço são a interface mais estável.
Localhost sempre aponta para o próprio namespace
Este talvez seja o problema mais comum de rede em Docker.
Dentro de um container:
localhost
aponta para o próprio container.
Se a API tenta conectar em:
localhost:5432
ela está procurando PostgreSQL no mesmo network namespace.
Se o banco está em outro container, o endereço correto é o nome daquele serviço na rede compartilhada:
db:5432
Se o banco está no host, a solução depende do ambiente e da configuração. Docker Desktop oferece nomes especiais como host.docker.internal em cenários suportados. Em Docker Engine nativo, pode ser necessário configurar acesso ao gateway do host.
A regra mental é mais importante do que decorar a solução:
Cada network namespace possui seu próprio localhost.
Quando dois serviços estão em containers diferentes, eles não compartilham loopback apenas porque executam na mesma máquina física.
EXPOSE não publica porta
Uma imagem pode conter:
EXPOSE 8080
Isso documenta que o serviço espera utilizar determinada porta.
Não significa que a porta foi aberta no firewall do host.
Não significa que ela está acessível pela internet.
Para publicar, você usa:
docker run -p 8080:8080 minha-api:1.0
O primeiro valor é a porta no host.
O segundo é a porta no container.
host:container
Adicionar um endereço:
docker run -p 127.0.0.1:8080:8080 minha-api:1.0
restringe o bind ao loopback do host.
A documentação de publicação de portas alerta que, sem endereço específico, portas publicadas ficam disponíveis nos endereços do host e podem ser acessíveis externamente.
Docker implementa isso por regras de firewall, NAT e encaminhamento.
Essa interação pode surpreender quem usa UFW e imagina que uma política simples de entrada controla automaticamente tudo que Docker publica. Eu entrei melhor nesse problema no post sobre UFW, firewalls e Docker.
Publicar porta é uma decisão de exposição.
Não apenas uma etapa obrigatória para “fazer funcionar”.
Container conectado não significa porta publicada
Containers na mesma rede definida pelo usuário conseguem se comunicar diretamente pelas portas do serviço.
Não é necessário publicar a porta do banco no host apenas para que a API consiga acessá-lo.
Em uma aplicação com API e PostgreSQL, somente a API talvez precise de uma porta publicada.
O banco pode permanecer acessível apenas na rede interna do projeto.
Isso reduz exposição e simplifica a topologia.
Em Compose:
services:
  api:
    build: .
    ports:
      - "127.0.0.1:8080:8080"

  db:
    image: postgres:17-alpine
Os dois serviços entram, por padrão, em uma rede do projeto.
A API consegue usar:
db:5432
O host não consegue acessar o banco diretamente porque nenhuma porta foi publicada.
EXPOSE, porta interna e porta publicada são três ideias relacionadas, mas diferentes.
Docker modifica firewall e roteamento
Para criar redes bridge, NAT e publicação de portas, Docker administra regras no host.
Dependendo da versão e configuração, isso envolve iptables, nftables ou camadas de compatibilidade.
Desabilitar a manipulação de regras do Docker pode quebrar conectividade dos containers.
Ao mesmo tempo, ignorar que essas regras existem pode produzir exposição acidental.
Por isso, comandos como:
docker ps
docker port web
ss -tulpen
e testes a partir de outra máquina são mais confiáveis do que assumir que a porta está protegida porque uma regra mental diz que deveria estar.
Rede de container não substitui entendimento básico de rede.
Ela apenas adiciona mais uma camada para entender.
Imagens multi-arquitetura
Uma mesma referência de imagem pode funcionar em máquinas amd64 e arm64.
Isso não significa que o mesmo binário execute diretamente em qualquer CPU.
Registries podem armazenar um image index, ou manifest list, que aponta para manifestações diferentes conforme plataforma.
Quando você executa:
docker pull nginx:alpine
o cliente e o daemon negociam a variante compatível com a arquitetura e o sistema operacional.
Por isso, o digest do índice pode ser diferente do digest da manifestação específica baixada para sua plataforma.
Também é possível forçar:
docker run --platform linux/amd64 imagem
Em uma máquina ARM, isso pode depender de emulação, como QEMU, e apresentar diferença de desempenho ou compatibilidade.
Multi-arch não significa binário universal.
Significa uma referência capaz de apontar para artefatos distintos.
Compose é um modelo da aplicação
Executar um container isolado pela CLI é simples.
Aplicações reais normalmente possuem API, banco, cache, fila, worker, proxy e ferramentas auxiliares.
Repetir vários comandos docker run cria uma configuração distribuída entre histórico do shell, README e memória do desenvolvedor.
Docker Compose permite declarar serviços, redes, volumes e configurações em um arquivo YAML.
A documentação do Compose apresenta essa ferramenta como uma forma de controlar uma stack inteira por um único modelo.
Um exemplo:
services:
  api:
    build:
      context: .
    ports:
      - "127.0.0.1:8080:8080"
    environment:
      DATABASE_URL: postgres://app:app@db:5432/app
    depends_on:
      db:
        condition: service_healthy
    networks:
      - backend

  db:
    image: postgres:17-alpine
    environment:
      POSTGRES_USER: app
      POSTGRES_PASSWORD: app
      POSTGRES_DB: app
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U app -d app"]
      interval: 5s
      timeout: 3s
      retries: 10
    volumes:
      - db-data:/var/lib/postgresql/data
    networks:
      - backend

volumes:
  db-data:

networks:
  backend:
O arquivo não contém containers.
Ele descreve serviços.
Quando você executa:
docker compose up -d
Compose resolve o modelo, cria rede, volume e containers necessários.
Ver o estado:
docker compose ps
Acompanhar logs:
docker compose logs -f
Reconstruir imagens e atualizar:
docker compose up -d --build
Remover containers e redes do projeto:
docker compose down
Remover também volumes declarados:
docker compose down -v
A última opção merece respeito.
Ela pode apagar o volume do banco.
Comando curto não significa consequência pequena.
depends_on não resolve toda dependência
depends_on expressa relação entre serviços e pode controlar ordem de criação.
Isso não significa automaticamente que a dependência está pronta para receber tráfego.
Um processo PostgreSQL pode ter sido iniciado e ainda estar executando inicialização.
Um broker pode estar vivo e ainda não ter carregado configuração.
No exemplo anterior, usamos:
condition: service_healthy
para relacionar a API ao healthcheck do banco.
Mesmo assim, aplicações distribuídas devem implementar retries, timeouts e tolerância a indisponibilidade.
O banco pode reiniciar depois que a API já está rodando.
Rede pode falhar.
Credenciais podem estar erradas.
Uma aplicação que só funciona se todas as dependências estiverem perfeitas no primeiro milissegundo de boot não está pronta para containers.
Talvez também não esteja pronta para computadores.
Compose não é um orquestrador de cluster completo
Compose resolve muito bem a descrição de uma aplicação em um ambiente Docker.
Ele é excelente para desenvolvimento, testes, homelab e diversas implantações em host único.
O problema muda quando existem vários servidores.
Agora alguém precisa decidir em qual nó cada workload executa. Se um nó falha, as instâncias precisam ser recriadas em outro. Atualizações precisam ocorrer gradualmente. Réplicas precisam ser distribuídas. Serviços precisam descobrir uns aos outros. Segredos e armazenamento precisam acompanhar o ciclo do cluster.
Nesse ponto aparece a orquestração.
Docker Swarm, Kubernetes e Nomad são exemplos de sistemas que trabalham com agendamento, estado desejado e reconciliação.
No Swarm mode, você descreve um serviço e a quantidade desejada de réplicas. O manager observa o estado real e tenta aproximá-lo do desejado.
No Kubernetes, control loops trabalham continuamente para reconciliar objetos declarados com o estado do cluster.
No Nomad, jobs descrevem workloads que serão alocados pelos schedulers.
O container continua sendo a unidade de execução em muitos desses cenários, mas surgem novas abstrações sobre ele.
Entram pods, tasks, services, deployments, allocations, nodes, schedulers, control planes e vários outros termos responsáveis por transformar “subir uma API” em uma profissão.
Este post só precisava chegar até a fronteira.
Orquestração merece um texto próprio, porque citá-la por três parágrafos e fingir que Kubernetes foi explicado seria uma pequena agressão pedagógica.
Como eu uso Docker
No meu fluxo, Docker e Compose aparecem em praticamente tudo.
Não apenas no deploy e nem apenas quando o projeto possui banco, cache e uma quantidade respeitável de serviços. Eu acho mais rápido começar um projeto já descrevendo o ambiente em containers do que instalar dependências no host, alinhar versões manualmente e depois tentar documentar o estado final da máquina.
Quando preciso montar um setup inicial, um ambiente de teste ou uma sandbox, normalmente começo pelo Dockerfile e pelo compose.yaml. Isso me permite definir runtime, dependências, portas, variáveis, volumes e serviços auxiliares no mesmo lugar em que o projeto é versionado.
Por muito tempo, eu nem mantive Node.js instalado diretamente no meu computador. Projetos Node, CLIs, scripts, builds e ferramentas que aceitassem esse fluxo eram executados em containers. Não porque instalar Node no host fosse particularmente difícil, mas porque eu preferia que cada projeto carregasse a própria versão e suas próprias dependências sem transformar a máquina em um histórico acumulado de decisões antigas.
Os incidentes de supply chain no ecossistema npm só reforçaram essa prática. Dependências são código, scripts de instalação também são código e um npm install pode executar muito mais do que apenas copiar arquivos para node_modules.
Isso não significa que Docker transforme pacote malicioso em pacote seguro. O processo continua compartilhando o kernel, pode acessar a rede e terá acesso a tudo que for montado ou concedido ao container. Um repositório executado com --privileged, com o socket do Docker ou com o diretório pessoal inteiro montado possui uma fronteira bem menos interessante do que a palavra “container” sugere.
Ainda assim, o isolamento é uma camada útil. Para projetos de terceiros, principalmente repositórios Git desconhecidos ou que me parecem suspeitos, eu não executo a aplicação diretamente no host. Crio um setup Docker próprio, reviso o que será montado e deixo o código dentro de um ambiente descartável.
A diferença prática é que o projeto recebe um sistema de arquivos próprio, processos separados, limites configuráveis e apenas os acessos que eu decidi fornecer. Se ele precisa apenas do diretório do código, não existe motivo para enxergar todo o meu $HOME. Se não precisa controlar Docker, não recebe /var/run/docker.sock. Se não precisa de privilégios adicionais, não recebe --privileged.
Essa abordagem também facilita experimentação. Posso testar outra versão de runtime, reproduzir uma falha, montar um banco temporário ou destruir todo o ambiente sem precisar desfazer manualmente cada alteração feita na máquina.
Compose é especialmente útil nesse ponto. Em vez de lembrar uma sequência de comandos, eu descrevo o ambiente:
docker compose up --build
Quando termino:
docker compose down
Se o ambiente é realmente descartável e os volumes também podem desaparecer:
docker compose down -v
Eu ainda preciso prestar atenção no que está sendo apagado, no que foi montado e no que possui persistência. Docker reduz o trabalho de montar e desmontar o laboratório. Ele não decide sozinho quais dados eram importantes.
No meu caso, portanto, Docker não é uma ferramenta reservada para aplicações grandes ou para a etapa final de infraestrutura. Ele é parte do ambiente de desenvolvimento, da reprodução de bugs, dos testes e da forma como reduzo a exposição do host a código que não conheço.
Isso adiciona uma camada.
Mas é uma camada que eu prefiro definir explicitamente a deixar espalhada pela máquina.
O que eu verifico em uma imagem
Uma imagem razoável não precisa vencer concurso de menor quantidade de megabytes.
Ela precisa ser compreensível, reproduzível o suficiente para o contexto e adequada ao runtime.
Eu observo a imagem base, a origem dos pacotes, a quantidade de ferramentas incluídas, o usuário padrão, o processo principal, a estratégia de sinais e a forma como configuração entra.
Também verifico se o build está carregando arquivos desnecessários e se segredos podem ter ido parar em camadas.
Para inspeção:
docker image inspect minha-api:1.0
Ver histórico:
docker image history minha-api:1.0
Ver uso de disco:
docker system df
Testar usuário:
docker run --rm minha-api:1.0 id
Testar processo:
docker run --rm minha-api:1.0
Listar detalhes do container criado:
docker inspect nome-do-container
Ferramentas externas podem analisar vulnerabilidades, SBOMs e conteúdo de camadas, mas a base continua sendo entender o que a imagem pretende conter.
Scanner não corrige arquitetura.
Ele apenas torna algumas decisões ruins mais fáceis de localizar.
latest não significa mais recente de forma confiável
latest é apenas uma tag.
Ela não recebe automaticamente a versão mais nova por uma lei do registry.
O mantenedor decide para onde ela aponta.
Alguns projetos não atualizam latest como você imagina. Outros alteram frequentemente. Alguns nem publicam a tag.
Em desenvolvimento, isso pode ser aceitável.
Em produção, usar tags explícitas reduz surpresa:
postgres:17.6-alpine
Para máxima fixação, combine versão legível com digest no mecanismo de deploy.
Ainda assim, existe um trade-off.
Fixar completamente o digest evita mudanças silenciosas, mas também impede receber correções sem atualizar a referência.
A solução não é abandonar pinning.
É ter um processo para atualizar, testar e promover novas imagens.
Imutabilidade sem manutenção só preserva vulnerabilidade com muita consistência.
Reiniciar não é atualizar
Se uma imagem nova foi publicada sob a mesma tag, executar:
docker restart web
não baixa nada.
O container existente continua baseado na imagem usada durante sua criação.
Mesmo que você execute:
docker pull minha-api:1.0
o container antigo não troca de base.
Você precisa recriá-lo.
Em Compose:
docker compose pull
docker compose up -d
Compose compara a configuração e pode substituir containers conforme necessário.
Esse detalhe explica por que ferramentas de atualização trabalham recriando instâncias, não trocando a imagem por baixo de um processo ativo.
Container é descartável justamente para que atualização seja substituição.
docker commit existe, mas normalmente não é o fluxo
É possível transformar alterações de um container em uma nova imagem:
docker commit container imagem:nova
Isso pode ser útil para debug, investigação e casos específicos.
Como fluxo normal de build, é ruim.
As mudanças ficam difíceis de revisar e reproduzir. Você sabe o resultado, mas não possui uma descrição clara do processo.
Dockerfile e sistemas de build existem para que a imagem seja produzida a partir de instruções versionadas.
Imagem feita por commit lembra configuração manual de servidor.
Funciona.
Só não explica muito bem por quê.
Não monte o projeto inteiro por reflexo
Em desenvolvimento, este padrão é comum:
volumes:
  - .:/app
Ele é conveniente, mas pode esconder arquivos construídos na imagem, introduzir diferenças de filesystem, causar problemas de performance no Docker Desktop e misturar dependências do host com dependências do container.
Em projetos Node.js, por exemplo, montar o diretório inteiro pode esconder o node_modules instalado durante o build.
Então aparece outro volume:
volumes:
  - .:/app
  - /app/node_modules
Agora existe um volume anônimo protegendo dependências dentro do container.
Isso pode funcionar muito bem.
Também pode confundir quem não entende por que existe um diretório que parece montado duas vezes.
Mounts devem representar uma intenção.
Código fonte compartilhado, dados persistentes, configuração somente leitura ou cache.
Quando tudo vira volume porque o primeiro tutorial fez assim, o sistema de arquivos deixa de ser arquitetura e vira colagem.
Containers não substituem gerenciamento de configuração
Docker reduz dependência da configuração do host, mas não elimina configuração.
Variáveis de ambiente, arquivos, certificados, endpoints, credenciais e feature flags continuam existindo.
Colocar tudo em:
ENV DATABASE_PASSWORD=senha
não é uma solução.
Valores definidos na imagem passam a fazer parte do artefato e podem ser inspecionados.
Mesmo variáveis fornecidas em runtime podem aparecer em metadados, dumps, logs ou ferramentas de inspeção.
Para desenvolvimento, .env e Compose podem ser suficientes.
Para produção, segredos merecem mecanismos próprios de secret management, permissões, rotação e auditoria.
Containerizar uma aplicação mal configurada produz uma aplicação mal configurada em um formato muito portátil.
Limites também fazem parte da arquitetura
É comum definir imagem, rede e volume, mas esquecer CPU e memória.
Sem limites, um único serviço pode pressionar o host inteiro.
Com limites muito baixos, o kernel pode encerrar o processo por falta de memória ou a aplicação pode sofrer throttling difícil de diagnosticar.
Exemplo:
docker run \
  --memory 512m \
  --memory-reservation 384m \
  --cpus 1 \
  --pids-limit 256 \
  minha-api:1.0
O limite precisa conversar com a aplicação.
Uma JVM que acredita possuir toda a memória do host pode se configurar mal dentro de uma cota pequena, embora runtimes modernos tenham melhor consciência de containers.
Pools de conexão, quantidade de workers, caches e concorrência também precisam considerar recursos disponíveis.
Cgroup consegue limitar consumo.
Ele não escolhe uma configuração inteligente para sua aplicação.
Um container por responsabilidade, não por fetiche
Separar API, banco e worker em containers diferentes permite atualizar, escalar e observar cada responsabilidade de forma independente.
Isso não significa que cada processo do sistema precisa receber um container próprio.
Nginx cria workers. PostgreSQL cria processos auxiliares. Uma aplicação pode precisar de um pequeno init.
A recomendação “um processo por container” é melhor entendida como “uma responsabilidade principal por container”.
Quando um container precisa administrar banco, API, cron, proxy, fila e coletor de logs, ele começa a recriar um pequeno sistema operacional dentro da imagem.
Nesse ponto você perde parte da vantagem de separar ciclos de vida.
Por outro lado, dividir uma aplicação em vinte containers apenas para provar adesão arquitetural pode criar uma rede distribuída onde antes existia uma chamada de função.
Containers facilitam separação.
Eles não tornam toda separação boa.
Docker não torna a aplicação portátil para qualquer lugar
Imagens melhoram portabilidade, mas dentro de limites.
A arquitetura de CPU precisa ser compatível ou emulada.
O kernel precisa oferecer os recursos esperados.
Mounts, dispositivos, capabilities e políticas de segurança variam.
Uma aplicação que depende de:
/var/run/docker.sock
não é tão portátil quanto parece.
Uma imagem que exige GPU precisa de runtime, driver e integração compatíveis.
Um container que monta /home/usuario/projeto depende da estrutura daquele host.
Um serviço stateful depende de armazenamento, backup e latência.
Docker reduz a quantidade de diferenças.
Ele não transforma infraestrutura em detalhe irrelevante.
A melhor definição talvez seja portabilidade operacional dentro de um contrato.
Quanto mais estreito e explícito for esse contrato, mais previsível será a execução.
Imagem imutável, container mutável
Imagens são tratadas como conteúdo somente leitura.
Containers recebem uma camada mutável.
Essa combinação permite iniciar várias instâncias da mesma base e descartar cada uma sem alterar o artefato original.
Em produção, a prática saudável é tratar containers como substituíveis.
Não entre na instância, altere arquivo e espere que a mudança sobreviva à próxima recriação.
Corrija a imagem, a configuração ou o volume responsável.
Alterações manuais dentro do container criam drift.
O serviço fica diferente daquilo que o Dockerfile e o Compose descrevem.
Se a única cópia da correção está dentro de uma instância em execução, você não possui uma correção.
Você possui um segredo operacional prestes a desaparecer.
Docker Compose como documentação executável
Um bom compose.yaml não serve apenas para subir serviços.
Ele documenta relações.
Mostra quais imagens existem, quais portas são públicas, quais redes conectam os componentes, quais dados persistem e quais variáveis configuram cada serviço.
Ele não substitui documentação humana. Ainda assim, é muito melhor do que depender de uma sequência de comandos perdida no histórico do terminal.
Também permite revisar mudanças em Git.
Adicionar uma porta, trocar uma imagem ou remover um volume vira diff.
Essa é uma das partes que mais gosto no uso de Docker.
A infraestrutura mínima do projeto deixa de ser uma coleção de instruções e passa a ser um modelo executável.
Não completamente reproduzível.
Não automaticamente seguro.
Mas explícito o suficiente para reduzir bastante a arqueologia.
Quando Docker começa a não ser suficiente
Um único host é simples.
O daemon conhece os containers, redes e volumes daquela máquina.
Quando a aplicação precisa de mais capacidade ou disponibilidade, surgem perguntas novas.
O que acontece quando o host morre?
Onde uma nova réplica será iniciada?
Como atualizar dez instâncias sem derrubar o serviço?
Como distribuir tráfego?
Como montar armazenamento em outro nó?
Como garantir que um segredo chegue apenas ao workload correto?
Como reconciliar uma instância que desapareceu?
Políticas de restart ajudam dentro do mesmo host.
Compose ajuda a descrever a aplicação.
Nenhum dos dois, sozinho, transforma um conjunto de máquinas em cluster autogerenciado.
Orquestradores entram quando o problema deixa de ser iniciar containers e passa a ser manter um estado distribuído ao longo do tempo.
Eles trabalham com estado desejado.
Você declara que quer três réplicas.
O sistema observa que existem duas.
Então tenta criar outra.
Essa reconciliação contínua é a mudança conceitual mais importante.
Mas também traz consenso, scheduling, rede de cluster, storage distribuído, service discovery, rollout, permissões, operadores e um ecossistema inteiro de problemas que merecem espaço próprio.
Por enquanto, basta entender que Docker resolve muito bem a unidade de empacotamento e execução.
Orquestração resolve a coordenação dessas unidades em escala.
O que Docker realmente mudou
As primitivas de container já existiam.
O que Docker fez foi criar uma experiência compartilhável.
Dockerfile tornou a construção mais acessível.
Images tornaram dependências distribuíveis.
Registries criaram um fluxo de publicação.
A CLI tornou operações complexas legíveis.
Compose aproximou a topologia da aplicação do código.
OCI ajudou a transformar partes desse modelo em padrões independentes de um único produto.
O impacto não veio de uma invenção isolada.
Veio da integração.
Antes, containers eram uma técnica de sistemas.
Depois, viraram parte do fluxo cotidiano de desenvolvimento.
Isso também explica por que Docker recebe críticas contraditórias.
Para algumas pessoas, ele esconde complexidade demais.
Para outras, ainda expõe complexidade demais.
As duas podem estar certas.
Docker simplifica a entrada sem eliminar a infraestrutura.
Em algum momento, a abstração vaza.
Rede continua sendo rede. Disco continua enchendo. UID continua sendo número. Processo continua recebendo sinal. Kernel continua compartilhado. Banco continua precisando de backup.
O container não remove essas realidades.
Ele organiza onde elas aparecem.
Conclusão
Docker não é uma máquina virtual pequena.
Também não é apenas um comando para subir banco local.
É uma plataforma construída sobre processos, namespaces, cgroups, mounts, regras de rede, imagens em camadas, runtimes padronizados e uma arquitetura cliente-servidor.
A simplicidade do docker run existe porque muitas decisões foram agrupadas atrás de uma interface.
Entender essas decisões muda a forma de usar a ferramenta.
Imagem deixa de ser um arquivo misterioso.
Container deixa de ser uma máquina descartável em miniatura.
Volume deixa de ser um diretório mágico.
Porta publicada deixa de ser apenas dois números separados por dois pontos.
docker exec deixa de ser uma conexão SSH imaginária.
E docker stop deixa de ser um botão educado de desligar.
No meu uso, Docker é mais valioso quando reduz variação, documenta dependências e torna componentes substituíveis.
Ele é menos valioso quando vira uma obrigação arquitetural e toda aplicação recebe containers, redes e proxies apenas porque “é assim que se faz DevOps”.
No fim, Docker não tornou infraestrutura irrelevante.
Ele tornou parte dela empacotável.
E, honestamente, fazer a aplicação chegar ao servidor junto das dependências corretas já resolveu uma quantidade bastante respeitável de sofrimento.